Monorepo vs Polyrepo: Die Entscheidung, die bleibt
Zusammenfassung
Für die meisten Solo-Developer, die ein Produkt mit gemeinsamen Packages bauen, ist ein Monorepo 2026 die richtige Standardwahl. Diese Anleitung erklärt, was man wirklich gewinnt (nicht nur die Theorie), wann Polyrepo tatsächlich besser ist, welche CI/CD-Kosten anfallen, und wie KI-Tools wie Cursor und Claude Code die klassischen Tradeoffs verschoben haben. Plus drei konkrete Signale, die zeigen, dass es Zeit ist zu splitten.
Die Entscheidung zwischen Monorepo vs Polyrepo taucht vor jedem neuen Projekt auf, und die Antwort prägt Monate von CI/CD-Setup, Refactoring-Overhead und Team-Zugriffskontrolle. Für die meisten Solo-Developer, die ein Produkt mit gemeinsam genutztem Code bauen, ist 2026 Monorepo die richtige Standardwahl. Nicht weil es gerade trendy ist, sondern weil es die Publishing-Zeremonie weglässt, die Polyrepos erzwingen, sobald zwei Packages miteinander reden müssen. Falls eure Services vollständig unabhängig sind und nie Code teilen werden, ist Polyrepo simpler. Jeden anderen Fall muss man betrachten.
Es ist 22 Uhr. Ein neues Projekt nimmt Gestalt an: eine Backend-API, ein Package mit gemeinsamen TypeScript-Types, und ein Frontend-Dashboard, das unweigerlich beides nutzen wird. Zwei Browser-Tabs offen. Der Cursor blinkt.
Die meisten Artikel zu diesem Thema sind für 20-köpfige Engineering-Teams geschrieben, mit einem DevOps-Engineer, der Bazel konfiguriert. Das hier ist für Builder, die die Entscheidung treffen müssen, bevor der erste Commit landet. Weil eine Umstrukturierung nach sechs Monaten, wenn ihr echte User habt und eine CI-Pipeline, die ihr auswendig kennt, genau die Art Projekt-Momentum-Killer ist, die ein Side-Project zum Scheitern bringt.
Was ein Monorepo wirklich bringt (nicht die Lehrbuch-Version)
Die Standard-Erklärung ist: "Ein Repo, gemeinsame Dependencies, atomare Changes." Das stimmt alles. Aber was für einen Solo-Builder im Alltag tatsächlich zählt, ist konkreter: Ihr müsst Packages nicht veröffentlichen, um sie lokal zu nutzen.
In einem Polyrepo-Setup müsst ihr, falls shared-utils einen Fix braucht, der auch api-service betrifft, entweder eine neue Version von shared-utils veröffentlichen, die Dependency in api-service bumpen, auf CI warten und dann deployen. Oder ihr fallt auf npm link-Hacks zurück, die funktionieren bis sie es nicht tun. In einem Monorepo mit Workspaces ändert ihr den Code, und jedes Package, das ihn importiert, sieht die Änderung sofort. Keine Publishing-Zeremonie.
Hier sieht das mit pnpm workspaces aus, das minimale Overhead hat:
/packages
  /shared-types      ← direkt von api und web importiert
  /api
  /web
package.json         ← workspace root mit "workspaces" Feld
// api/package.json
{
"dependencies": {
"@myapp/shared-types": "workspace:*"
}
}Keine Veröffentlichung. Kein Version-Bumping während Development. workspace:* löst sich zu dem lokalen Package auf, und TypeScripts Project References geben euch inkrementelle Kompilation über den ganzen Graph.
Der zweite echte Vorteil: Cross-Package-Refactoring in einem einzigen PR. Ein Interface in shared-types umbenennen? TypeScript sagt euch, welche Consumers broke, im selben Codebase, in der selben Editor-Session. In einem Polyrepo: Ihr benennt es in Repo A um, veröffentlicht eine neue Version, und entdeckt den Schaden in Repo B drei Tage später, wenn ein Colleage npm install laufen lässt und die Types nicht mehr zur Laufzeit passen.
Der dritte Vorteil, den Solo-Developer unterschätzen: Ein Ort für Tooling-Config. Ein .eslintrc, eine prettier.config.js, eine CI-Workflow-Datei. Kleine Ersparnisse pro Change, aber sie summieren sich über Monate Iteration.
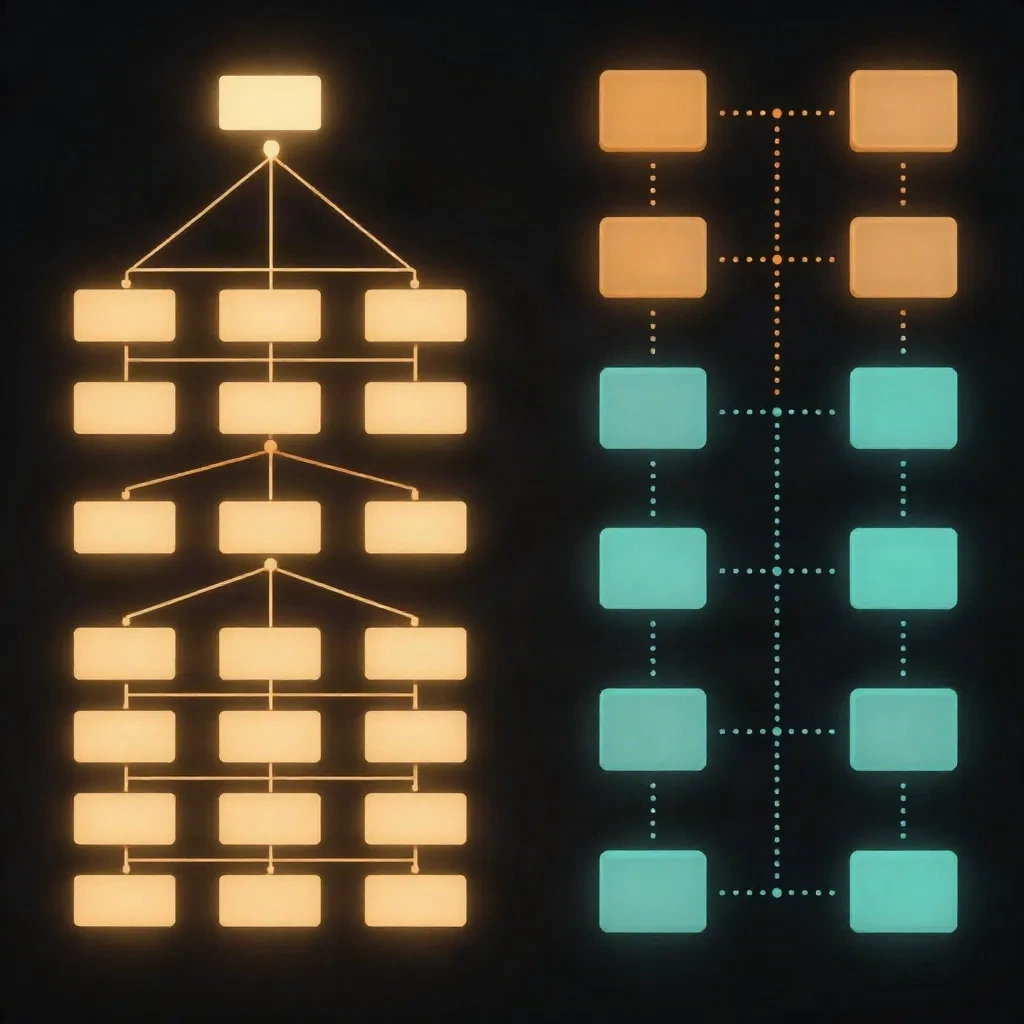
Es lohnt sich zu nennen, was ein Monorepo nicht tut: Es macht Services nicht weniger gekoppelt. Wenn eure Services echt unabhängig sind und ihr sie trotzdem in einem Monorepo unterbringt, habt ihr Koordinations-Overhead ohne Gegenwert. Die Vorteile des Monorepos materialisieren sich nur, wenn die Services tatsächlich Code teilen oder zusammen ändern müssen. Die Repo-Struktur sollte die Dependency-Struktur widerspiegeln, nicht eine erzwingen.
Wann Polyrepo seinen Platz verdient
Polyrepo ist nicht falsch. Es ist die richtige Wahl für bestimmte Situationen, und wer das leugnet, endet mit einem 40-Service-Monorepo, das 25 Minuten zum Clonen braucht.
Der klarste Fall: Services mit wirklich unterschiedlichem Ownership, Release-Cycle oder Compliance-Anforderungen. Falls euer Billing-Service PCI-scoped ist und eure Marketing-Site nicht, hält ein separates Repo Access Control, Audit Logs und Blast Radius sauber getrennt. Das ist nicht Overhead. Das ist das Feature.
Polyrepo gewinnt auch, wenn ihr einen Teil eures Codebases open-sourcen wollt. Ein dediziertes Public Repo lässt externe Contributor forken und PR machen, ohne eure private Infrastruktur reinzuziehen. GitHubs Repository-Level-Permission-Modell gibt euch keine saubere path-basierte Access-Isolation in großem Maßstab. Ein separates Repo macht das richtig.
Und für pure Microservices mit völlig unterschiedlichen Tech Stacks: Ein Go-Service und eine React-Native-App, die auf Code-Ebene absolut nichts teilen. Ein Monorepo fügt Koordinations-Kosten ohne Gegenwert. Wenn es keine Shared Packages gibt, gibt es nichts zu teilen.
Die ehrliche Version: Die meisten Indie-Projekte, die mit Polyrepo starten, bereuen es später, nicht weil Polyrepo schlechte Architektur ist, sondern weil sie überschätzt haben, wie unabhängig die Teile bleiben würden. Das Frontend braucht immer einen Type vom Backend. Der Worker braucht immer ein Utility von der API. Zwei Repos werden zu vier PRs pro Feature.
Der CI/CD-Overhead, den keiner erwähnt, bis die Rechnung kommt
Monorepos haben echte Operational Costs: Falls euer CI naiv alles bei jedem Commit laufen lässt, zahlt ihr in Zeit und Geld für Builds und Tests, die mit eurer Änderung nichts zu tun haben.
Einen CSS-Tweak zum web-Package pushen. CI läuft die komplette Test-Suite für api, worker und shared-types. Das sind sechs Minuten GitHub Actions für eine Farbe. In größerem Maßstab wird das zu CI-Queues, die euer ganzes Team blockieren.
Die Lösung existiert, braucht aber bewusste Setup: Build-Orchestration-Tools, die euren Dependency-Graph verstehen. Turborepo und Nx lösen das beide. Turborepos turbo.json definiert eine Pipeline, wo jede Task nur für Packages mit geänderten Inputs läuft:
{
  "pipeline": {
    "build": {
      "dependsOn": ["^build"],
      "outputs": ["dist/**"]
    },
    "test": {
      "dependsOn": ["build"],
      "cache": true
    }
  }
}
Mit Remote Caching aktiv (kostenlos auf Vercels Turborepo Cloud für kleine Teams) ist ein Cache Hit auf einem ungeänderten Package instant, kein Rebuild, kein Retest. Für einen Solo-Dev auf einem Side-Project hält das CI unter zwei Minuten auf den meisten Pushes, sobald die Build-Artifacts warm sind.
Die Kosten: Ihr müsst Turborepo oder Nx lernen, bevor ihr es braucht, nicht danach. Das ist ungefähr ein halber Tag Setup. Falls ihr das überspringt und CI wird fett, wird Monorepo CI so langsam, dass ihr anfangt, die ganze Architektur-Wahl zu hinterfragen. Meistens entscheiden sich Developer dann, dass Polyrepo doch richtig war, dabei war das echte Problem nur eine fehlende Config-Datei.
Wie KI-Coding-Tools die Rechnung verschoben haben
Bis vor kurzem war eine echte Argument für Polyrepo die Cognitive Load: Kleinere Repos sind einfacher zu verstehen, weil sie isoliert sind. Context-Switch zu einem neuen Service, seht nur was für den Service relevant ist. Das Argument war berechtigt.
KI-Coding-Tools verschieben die Berechnung. Wenn ihr mit Cursor, Claude Code oder GitHub Copilot arbeitet, sieht das Tool euren kompletten Codebase in Context. Es sieht Cross-Service-Dependencies, versteht welches Interface von welchem Service konsumiert wird, und kann ein umbenanntes Feld durch jeden Consumer tracken ohne dass ihr das mentale Modell halten müsst. Das "isoliertes Repo ist einfacher zu verstehen" Argument wird signifikant schwächer, wenn euer KI-Assistant den ganzen Dependency-Graph im Context hält.
Ein konkretes Beispiel: In einem Polyrepo-Setup können KI-Assistenten normalerweise nicht beide Repos in einer Session sehen, wenn ihr sie fragt, einen API-Endpoint zu refaktorieren, der auch einen Shared Type betrifft. Ihr koordiniert manuell, was genau der Overhead war, den ein Monorepo beheben sollte. In einem Monorepo ist das ein Gespräch.
Das flipt nicht die ganze Entscheidung. Aber es nimmt eine der historischen Rechtfertigungen für Polyrepo bei kleinen Teams und Solo-Devs weg, und kippt das Default leicht weiter Richtung Monorepo, wenn der Code wirklich gekoppelt ist.
Drei Signale, dass ihr jetzt das Repo splitten solltet
Ihr seid mit Monorepo gestartet. Gut. Aber hier sind konkrete Signale, dass der Split die richtige Wahl geworden ist:
Access Control wird Last-bearing. Ein Contractor braucht Frontend-Zugriff, nicht Backend. Ein Partner-Integration-Team braucht eure API-Schema zu lesen, aber nichts Proprietäres. GitHubs Codeowners können einschränken, wer welche Paths reviewen kann, aber sie schränken Read-Access nicht ein. Falls Read-Isolation für Compliance oder Security zählt, sind separate Repos die saubere Antwort. Codeowners-Gymnastik ersetzt Repository-Level-Permissions nie.
CI-Failures in einem Service blockieren Deployment in einem unrelated. Falls ein broken Test in payment-service euren Hotfix in marketing-site gatet, erzeugt euer Monorepo Kopplung, die euer Codebase nicht hat. Entweder die Build-Config muss fixed werden (Task-Scoping mit Turborepo löst das), oder die Services gehören wirklich nicht ins selbe Repo.
Ein Teil geht Open-Source und einer nicht. Das ist der sauberste Split-Case. Extrahiert das Open-Source-Teil in ein eigenes Public Repo. Gemischter öffentlicher und privater Code in einem GitHub-Monorepo ist wirklich schmerzhaft: Ihr braucht eine separate Organization oder einen manuellen Pruning-Prozess, der permanenten Maintenance-Overhead erzeugt.
Das praktische Setup, wo die meisten Builder landen
Die Antwort, auf der erfahrene Developer landen: Ein Monorepo pro Product-Domain, nicht "ein Monorepo für alles, was ihr je gebaut habt" und nicht "ein Repo pro Package".
Wenn ihr ein SaaS mit Web-Frontend, API und Shared-Type-Library baut, das ist eine Produkt. Haltet es in einem Monorepo. Falls ihr auch eine Open-Source CLI-Utility unterstützt, die andere Projekte nutzen, das ist ein anderes Repo mit anderer Audience und Release-Cycle.
Der Fehler ist, die Monorepo/Polyrepo-Wahl als ideologisch zu behandeln. Es ist nicht "Monorepo-Teams" gegen "Polyrepo-Teams". Es ist eine strukturelle Entscheidung basierend auf drei Fragen: Wie sieht euer Dependency-Graph zwischen Services aus? Wer braucht Zugriff auf was, und zählt Isolation? Wie viel CI/CD-Setup-Komplexität vertragt ihr?
Für Side-Projects speziell: Startet mit Monorepo mit pnpm workspaces (npm workspaces funktionieren auch, sind nur weniger ergonomisch). Fügt Turborepo nur hinzu, wenn eure CI regelmäßig 4+ Minuten braucht. Splittet in ein separates Repo nur, wenn ihr einen konkreten Grund habt: Open-Source, Access Control, Compliance, oder ein Partner-Team mit anderer Release-Cadence. Nicht weil es architektonisch sauberer wirkt.
Die Monorepo-vs-Polyrepo-Debatte ist eine dieser Entscheidungen, wo die richtige Antwort für die meisten Solo-Developer dieselbe ist: Startet einfach, optimiert wenn die konkrete Reibung auftaucht. Der Cursor blinkt noch. Macht den ersten Commit.