Monorepo vs polyrepo: la decisión de stack que se mantiene
Resumen
Para la mayoría de desarrolladores independientes que arman un producto con paquetes compartidos, un monorepo es la opción por defecto en 2026. Esta guía explica qué ganas realmente más allá del pitch, cuándo polyrepo efectivamente gana, qué costos esperar en CI/CD, y cómo herramientas IA como Cursor y Claude Code modificaron los tradeoffs clásicos. Más tres señales concretas que te avisan cuándo es momento de separar en repos.
La pregunta monorepo vs polyrepo aparece antes de cada proyecto nuevo, y la respuesta moldea meses de setup en CI/CD, refactoring, y control de acceso. Para la mayoría de desarrolladores independientes que construyen un producto con código compartido, la opción por defecto en 2026 es monorepo. No porque sea la moda, sino porque elimina la ceremonia de publicación que los polyrepos imponen en el momento en que dos paquetes necesitan comunicarse. Si tus servicios son completamente independientes y genuinamente nunca van a compartir código, polyrepo es más simple. Todo otro caso es contexto.
Son las 22h. Tenés un proyecto nuevo tomando forma: una API backend, un paquete de tipos TypeScript compartidos, y un dashboard frontend que inevitablemente consumirá ambos. Dos tabs abiertos. El cursor parpadeando.
La mayoría de posts sobre este tema están escritos para equipos de veinte ingenieros con un DevOps dedicado que disfruta configurar Bazel. Este es para builders que necesitan tomar la decisión antes del primer commit, porque reestructurar seis meses después, cuando ya tenés usuarios reales y un pipeline de CI que tu memoria muscular memorizó, es exactamente lo que mata la pista de momentum en un side project.
Qué un monorepo realmente te compra (no la versión textbook)
El pitch estándar es "un repo, dependencias compartidas, cambios atómicos". Todo eso es real. Pero la parte que realmente importa día a día para un builder solo es más concreta: no tenés que publicar paquetes para usarlos localmente.
En un setup polyrepo, si shared-utils necesita un fix que también afecta api-service, o publicás una nueva versión de shared-utils, actualizás la dependencia en api-service, esperás a que CI pase, y después desplegás. O caés en hacks de npm link que funcionan hasta que dejan de funcionar a mitad de sprint. En un monorepo con workspaces, cambiás el código, y cada paquete que lo importa ve el cambio inmediatamente. Sin ceremonia de publicación.
Acá va cómo se ve con pnpm workspaces, que agrega overhead de configuración mínimo:
/packages
  /shared-types      ← importado directamente por api y web
  /api
  /web
package.json         ← workspace root con campo "workspaces"
// api/package.json
{
"dependencies": {
"@myapp/shared-types": "workspace:*"
}
}Sin publicación. Sin bumping de versión durante desarrollo. workspace:* resuelve al paquete local, y las project references de TypeScript te dan compilación incremental en todo el grafo.
El segundo beneficio real: refactoring entre paquetes que aterrizan en un PR. ¿Renombrás una interfaz en shared-types? TypeScript te dice cada consumidor que rompiste, en el mismo codebase, en la misma sesión del editor. En polyrepo, la renombrás en repo A, publicás una nueva versión, y descubrís el problema en repo B tres días después cuando un colega corre npm install y los tipos no matchean con el runtime.
El tercer beneficio, que los devs independientes subestiman: un único lugar para la configuración de herramientas. Un .eslintrc, un prettier.config.js, un archivo de workflow de CI. Pequeñas economías por cambio, pero se acumulan en meses de iteración.
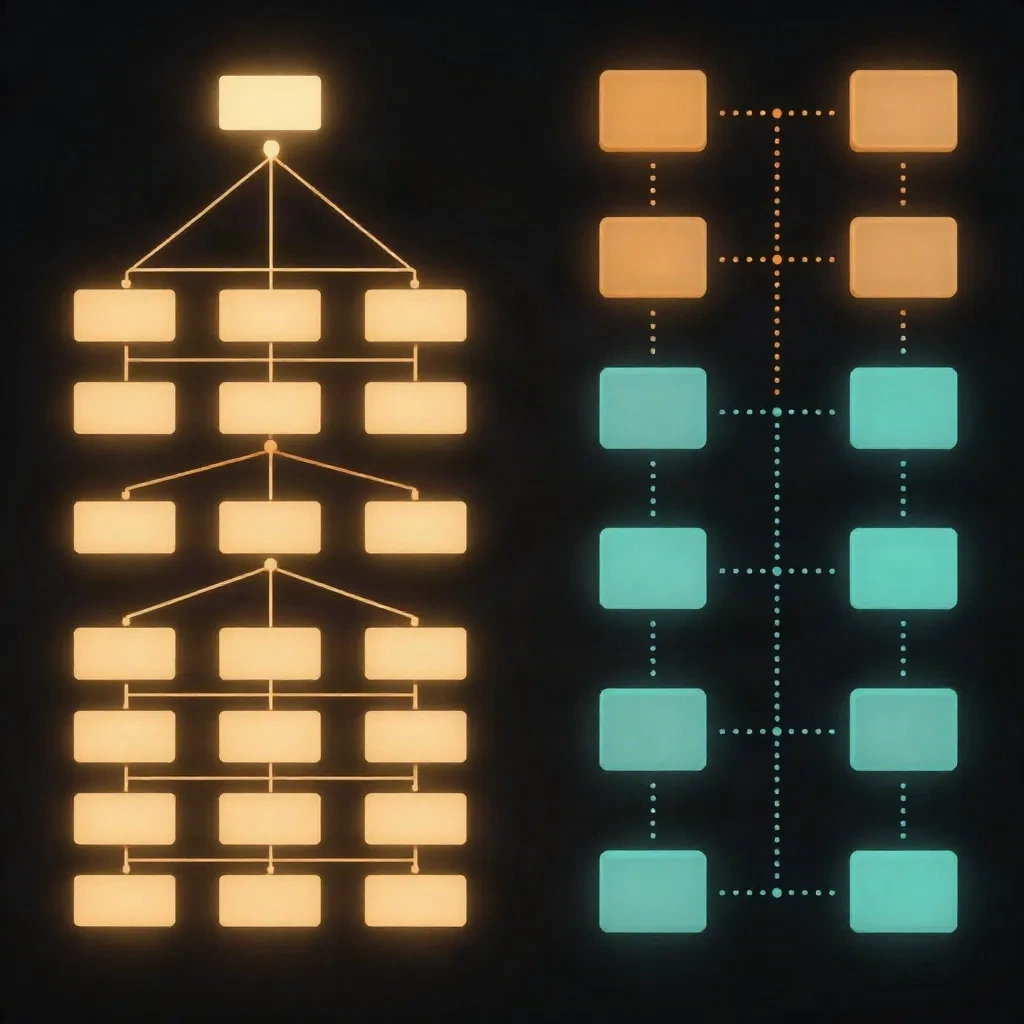
Vale aclarar qué un monorepo NO te da: no hace los servicios menos acoplados. Si tus servicios son genuinamente independientes y los metes en un monorepo igual, sumaste overhead de coordinación sin retorno. Los beneficios del monorepo se materializan solo cuando los servicios efectivamente comparten código o necesitan cambiar juntos. La estructura del repo debería reflejar la estructura de dependencias, no imponer una.
Cuándo polyrepo se gana su lugar
Polyrepo no es un error. Es la opción correcta para situaciones específicas, y pretender lo contrario es cómo terminas con un monorepo de 40 servicios que tarda 25 minutos en clonar.
El caso más claro: servicios con ownership genuinamente diferente, ciclos de release distintos, o requerimientos de compliance divergentes. Si tu servicio de billing está bajo scope PCI y tu sitio de marketing no, mantenerlos en repos separados significa tener aislamiento limpio de control de acceso, logs de auditoría, y blast radius. Eso no es overhead operacional. Eso es la feature.
Polyrepo también gana cuando estás open-sourceando parte del codebase. Un repo público dedicado le deja a los contribuyentes externos hacer fork y PR sin meter tu infraestructura privada en scope. El modelo de permisos por repositorio de GitHub no te da aislamiento limpio basado en paths a escala. Un repo separado lo maneja correctamente.
Y para microservicios puros con tech stacks completamente distintos: un servicio en Go y una app React Native que literalmente no comparten nada a nivel de código, un monorepo suma costo de coordinación sin entregar el beneficio. Si no hay paquetes compartidos, no hay nada que compartir.
La versión honesta: la mayoría de proyectos indie que empiezan con polyrepo terminan arrepintiéndose, no porque polyrepo sea mala arquitectura, sino porque sobreestimaron qué tan independientes se mantendrían las partes. El frontend siempre termina necesitando un tipo del backend. El worker siempre necesita una utilidad de la API. Dos repos se convierten en cuatro PRs por cada feature.
El costo de CI/CD que nadie menciona hasta que golpea tu factura
Los monorepos tienen un costo operacional real: si tu CI ingenuamente corre todo en cada commit, estás pagando en tiempo y dinero por builds y tests que no tienen nada que ver con lo que cambiaste.
Pusheás un ajuste de CSS al paquete web. CI corre la suite completa de tests para api, worker, y shared-types. Eso son seis minutos de compute de GitHub Actions por un cambio de color. A escala, esto se convierte en colas de CI que bloquean a todo el equipo.
La solución existe, pero requiere setup deliberado: herramientas de orquestación de builds que entienden tu grafo de dependencias. Turborepo y Nx resuelven esto. El turbo.json de Turborepo define un pipeline donde cada tarea corre solo para paquetes con inputs modificados:
{
  "pipeline": {
    "build": {
      "dependsOn": ["^build"],
      "outputs": ["dist/**"]
    },
    "test": {
      "dependsOn": ["build"],
      "cache": true
    }
  }
}
Con caching remoto habilitado (gratis en el tier gratuito de Vercel Turborepo Cloud para equipos chicos), un cache hit en un paquete sin cambios es instantáneo, sin rebuild, sin retest. Para un dev independiente en un side project, esto mantiene CI bajo dos minutos en la mayoría de pushes una vez que los artefactos están calientes.
El costo: necesitás aprender Turborepo o Nx antes de necesitarlo, no después. Son aproximadamente media jornada de setup. Si lo saltás y dejás que CI acumule grasa, el monorepo CI se va a ralentizar hasta el punto donde empezás a cuestionarte la decisión arquitectónica completa, y generalmente es cuando los devs deciden que polyrepo era lo correcto después de todo, cuando el problema real era solo un archivo de config faltante.
Cómo las herramientas de IA modificaron la matemática del debate
Hasta hace poco, un argumento genuino para polyrepo era carga cognitiva: repos más chicos son más fáciles de razonar porque están aislados. Cambias de contexto a un servicio nuevo, ves solo lo relevante para ese servicio. El argumento era legítimo.
Las herramientas de IA modifican ese cálculo. Cuando trabajás con Cursor, Claude Code, o GitHub Copilot, la herramienta trabaja con tu codebase completo en contexto. Ve dependencias cross-service, entiende qué interfaz es consumida por qué servicio, y puede rastrear un campo renombrado en cada consumidor sin que vos mantengas el modelo mental completo. El argumento "repo aislado es más fácil de entender" se debilita significativamente cuando tu asistente IA sostiene el grafo de dependencias entero en contexto.
Un ejemplo concreto: en un setup polyrepo, si le pedís a un asistente IA que refactorice un endpoint de API que también afecta a un tipo compartido, típicamente no puede ver ambos repos en una sesión. Estás coordinando manualmente, que es exactamente el overhead que un monorepo estaba supuesto de eliminar. En un monorepo, el mismo refactor es una conversación.
Esto no invierte la decisión completamente. Pero elimina una de las justificaciones históricas para polyrepo en equipos pequeños y devs independientes, y inclina el default un poco más hacia monorepo cuando el código genuinamente está acoplado.
Tres señales que significan que deberías separar el repo ahora
Empezaste con un monorepo. Bien. Pero acá van las señales concretas de que la separación se convirtió en la opción correcta:
El control de acceso está volviéndose fundamental. Un contractor necesita acceso a frontend, no a backend. Un equipo de integración de partner necesita leer tu schema de API pero nada propietario. El Codeowners de GitHub puede restringir quién puede revisar qué paths, pero no restringe acceso de lectura. Si el aislamiento de lectura importa por compliance o seguridad, repos separados son la respuesta limpia. Las gymnastics de Codeowners nunca reemplazan completamente los permisos a nivel de repositorio.
Los fallos de CI en un servicio están bloqueando deployment en otro no relacionado. Si un test roto en payment-service está gatillando un hotfix que necesitás shippear en marketing-site, tu monorepo está creando acoplamiento que tu codebase no tiene. O la configuración de build necesita fixing (scoping de tareas con Turborepo lo soluciona), o los dos servicios genuinamente no pertenecen al mismo repo.
Una parte va a ser open-source y la otra no. Este es el caso más limpio de split. Extrae la pieza open-source a su propio repo público. Código mixto público/privado en un monorepo de GitHub es genuinamente arduo: necesitarías una organización separada o un proceso de pruning manual que crea overhead de mantenimiento permanente.
El setup práctico donde terminan la mayoría de builders
La respuesta donde terminan los devs experimentados: un monorepo por dominio de producto, no "un monorepo para todo lo que armaste nunca" y no "un repo por paquete".
Si estás armando un SaaS con un frontend web, una API, y una librería de tipos compartida, eso es un producto. Mantenelo en un monorepo. Si además mantenés una herramienta CLI open-source que otros proyectos usan, ese es un repo diferente con una audiencia diferente y ciclo de release distinto.
El error es tratar la decisión monorepo/polyrepo como ideológica. No es "equipos monorepo" versus "equipos polyrepo". Es una decisión estructural basada en tres preguntas: ¿Cuál es el grafo de dependencias entre tus servicios? ¿Quién necesita acceso a qué, y importa el aislamiento? ¿Cuál es tu tolerancia al complexity de setup en CI/CD?
Para side projects específicamente: empieza con un monorepo usando pnpm workspaces (npm workspaces funciona también, solo menos ergonómico). Suma Turborepo solo cuando tu CI empieza a golpear regularmente 4+ minutos. Separa en repo diferente solo cuando tenés una razón concreta: open-source, control de acceso, compliance, o un equipo partner con cadencia de release distinta. No porque se sienta más limpio arquitectónicamente.
El debate monorepo vs polyrepo es una de esas decisiones donde la respuesta correcta para la mayoría de devs independientes es la misma: empieza simple, optimiza cuando la fricción específica aparece. El cursor sigue parpadeando. Shippea el primer commit.