Qué es un despliegue canary: guía práctica para devs
Resumen
Un despliegue canary envía la nueva versión de tu app a una pequeña parte del tráfico real, a menudo entre el 1% y el 5%, antes de que la reciba todo el mundo. Comparas la tasa de errores y la latencia con la versión estable, amplías la porción si se mantiene sana y devuelves el peso del canary a cero si no. Limita el daño de una mala publicación, pero exige métricas por versión y tráfico suficiente para que la comparación signifique algo.
¿Qué es un despliegue canary? Es una publicación en la que la nueva versión de tu app recibe primero una pequeña porción de tráfico real, por ejemplo entre el 1% y el 5%, mientras el resto de usuarios sigue en la versión anterior. Vigilas la tasa de errores y la latencia de esa porción. Si todo va bien, la amplías. Si algo va mal, devuelves el tráfico a la versión estable y casi nadie se entera. Esa es la idea completa, y lo que sigue trata de hacerla funcionar en la práctica.
¿Por qué se llama canary?
Los mineros de carbón llevaban canarios bajo tierra porque los pájaros reaccionaban al gas tóxico antes que las personas. Un canario que dejaba de cantar era la señal para salir. Un despliegue canary funciona igual: un pequeño grupo de usuarios prueba primero el código nuevo y hace de sistema de alerta temprana. El glosario de CNCF lo describe como dos entornos, uno que sirve tráfico real y otro con el código actualizado, con el tráfico desplazado poco a poco, empezando por una porción pequeña como el 1%.
En la práctica, el problema es que los usuarios del canary son usuarios reales, y el staging no puede darte eso. En producción aparecen los navegadores raros, las cachés viejas y el cliente con un archivo de importación de 40 MB. Un canary es la forma de conocerlos antes de que todos se encuentren con tu bug.
¿Cómo funciona un despliegue canary en la práctica?
Son cuatro piezas, nada exótico.
Dos versiones corriendo a la vez. La antigua (estable) y la nueva (canary). Ambas tienen que poder atender peticiones al mismo tiempo.
Un repartidor de tráfico. Un balanceador de carga, un ingress controller, una malla de servicios o una regla de CDN que envía un porcentaje configurable al canary.
Métricas en las que confíes. Tasa de errores, latencia y al menos una señal de negocio, como el éxito del checkout o los registros.
Una regla para avanzar o abortar. Escrita antes del despliegue, no inventada a las 23:00 mientras miras las gráficas.
Una rampa típica sube así: 1%, 5%, 25%, 50%, 100%, con una pausa en cada paso. Google Cloud Deploy documenta la misma forma: defines una serie de porcentajes y la herramienta reparte el tráfico, con un ejemplo de fases del 25%, el 50% y el 75% antes de la versión estable final. La documentación de canary de Cloud Deploy también muestra que cada fase puede ejecutar un job de verificación y un paso de análisis para decidir si avanza.
No es una configuración perfecta. Es una configuración factible. No necesitas Kubernetes para hacerlo: una ruta con pesos en nginx, un Cloudflare Worker que cambia una cookie o dos máquinas de Fly.io detrás de un mismo proxy también sirven.
¿Cómo se ve el reparto de tráfico en una configuración?
Este es el ejemplo útil más pequeño: un upstream de nginx con pesos. Nueve de cada diez peticiones van a la versión estable y una va al canary.
upstream app {
    server 10.0.0.10:3000 weight=9;   # estable
    server 10.0.0.11:3000 weight=1;   # canary
}
Tiene un defecto que conviene conocer: el reparto es por petición, así que un mismo usuario puede rebotar entre versiones en clics consecutivos. Si tu nueva versión cambia la forma de una respuesta de API o una columna de la base de datos, ese usuario lo va a pasar mal. El enrutamiento persistente por cookie o por ID de usuario lo resuelve, y es lo primero que vale la pena añadir cuando el reparto básico ya funciona.
¿Qué vigilar mientras el canary está en marcha?
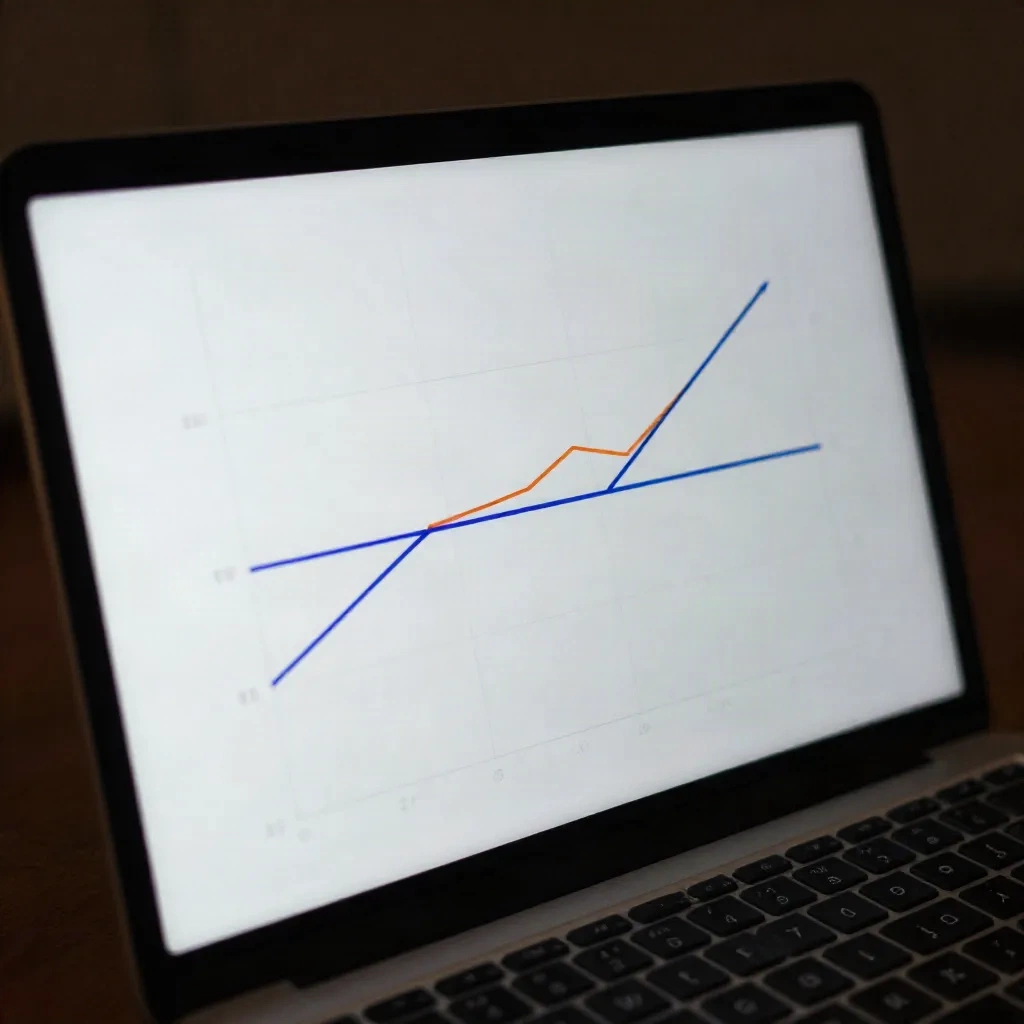
Compara el canary con la versión estable en el mismo momento, no con la semana pasada, porque la semana pasada tenía otro tráfico. La pregunta es siempre la misma: ¿el canary va peor que la versión que atiende al otro 95% ahora mismo?
Tasa de errores. Respuestas HTTP 5xx y excepciones no controladas, separadas por etiqueta de versión.
Latencia. p95 y p99, no la media. La media oculta la cola lenta, que es donde viven las regresiones.
Saturación. CPU, memoria y conexiones a la base de datos. Una fuga de memoria se ve como una pendiente, así que dale tiempo.
Una métrica de negocio. Si el éxito del checkout cae en el canary mientras los errores se mantienen planos, has lanzado un bug silencioso.
El error más habitual en los equipos pequeños es subir la rampa por temporizador: cinco minutos al 1% y luego al 25%, digan lo que digan las gráficas. Con poco tráfico, cinco minutos al 1% pueden ser seis peticiones, y eso no te dice nada. Espera a un número mínimo de peticiones, no a un número mínimo de minutos.
Las herramientas que automatizan esto valen la pena cuando ya tienes tráfico real.
Canary o blue-green: ¿cuál elegir?
Blue-green mantiene dos entornos completos y cambia todo el tráfico de golpe. El rollback es volver a cambiarlo, rápido y limpio. El coste es que durante un momento el 100% de los usuarios está en la versión nueva, y pagas el doble de infraestructura mientras dura el cambio.
Canary expone solo una porción, así que el radio de impacto es menor. El precio es la complejidad: necesitas pesos de tráfico, métricas por versión y una regla de decisión. El rollback consiste en poner el peso del canary a cero, lo cual es rápido pero no literalmente instantáneo si hay conexiones que drenar.
Tres razones para elegir canary, una para no hacerlo. Elige canary cuando un bug en producción sea caro, cuando tengas tráfico suficiente para que una porción pequeña signifique algo y cuando puedas comparar métricas por versión. Evítalo si tienes unas pocas docenas de usuarios al día: la porción canary estará estadísticamente vacía y estarás adivinando. A esa escala, blue-green o incluso un despliegue simple con un script de rollback rápido es la respuesta honesta.
Las actualizaciones continuas (rolling) están a medio camino. Reemplazan las instancias una a una, lo cual es suave, pero no son un experimento controlado: no eliges quién ve la versión nueva ni comparas cohortes.
¿Dónde encajan los feature flags?
Un despliegue canary reparte el tráfico entre versiones del código. Un feature flag reparte el comportamiento dentro de una misma versión. Mucha gente los confunde, y la confusión sale cara.
Despliegas el código nuevo para todos, oculto tras un flag desactivado. Luego activas el flag para el 1% de los usuarios, después para el 10% y por último para todos. A esto se le suele llamar canary release a nivel de funcionalidad. La ventaja: el rollback es apagar un flag, sin volver a desplegar. La desventaja: el código inactivo está en producción para todos, y los flags olvidados se convierten en deuda técnica.
Para un desarrollador en solitario, los flags suelen ser el primer paso más barato. Un booleano en una tabla de configuración y un hash del ID de usuario te dan cerca del 80% del valor. Si se te queda corto, un servicio gestionado se encarga de la segmentación, los logs de auditoría y los despliegues graduales por porcentaje.
¿Qué sale mal con los canary en proyectos reales?
Probado. No es lo óptimo. Esto es por qué lo hacemos igual. Estos son los fallos que de verdad muerden.
Migraciones de base de datos. Ambas versiones tocan la misma base de datos a la vez. Si el canary elimina o renombra una columna, la estable se rompe. La solución es el patrón expand and contract: primero añades la columna nueva, despliegas código que maneje las dos formas y eliminas la antigua solo en una versión posterior. Si te saltas esto, tu canary tumba la versión estable.
Sesiones con estado. Si las sesiones viven en memoria en una instancia, un usuario que rebota entre versiones se desconecta. Mueve el estado de sesión a un almacén compartido antes de intentar canarios.
Envenenamiento de caché. Una versión nueva que escribe un formato de caché distinto puede corromper lo que lee la versión antigua. Versiona tus claves de caché.
Trabajos en segundo plano. El canary también consume mensajes de la cola. Un worker con errores puede devorar trabajos a toda velocidad, porque el porcentaje de tráfico no limita el consumo de colas. Dale al canary su propia cola o un peso de consumidor.
Alertas que nadie configuró. El canary puede fallar a gritos en un panel que nadie abre. Un aborto automático por umbral gana a una persona mirando, sobre todo a las 2 de la madrugada en Taipéi o en Bangkok, cuando la única persona despierta es quien desplegó.
¿Cómo empezar con un canary en un proyecto personal?
Empieza más pequeño de lo que crees que deberías. Eres un dev, no un equipo de plataforma.
Etiqueta cada métrica con una versión. Pon el SHA de git en una cabecera y en tus logs. Sin esto no puedes comparar canary y estable.
Elige una sola regla de aborto. Por ejemplo: si la tasa de errores del canary supera el doble de la de la estable durante cinco minutos, haces rollback. Una regla, escrita.
Añade una ruta con pesos. Pesos en nginx, una regla de Cloudflare o la función de reparto de tráfico de tu hosting. La mayoría de plataformas gestionadas ya ofrecen enrutamiento por porcentaje sin herramientas extra.
Despliega algo aburrido primero. Un cambio de texto, no el rediseño de la página de precios. Practica la rampa y el rollback cuando no hay nada en juego.
Cronometra el rollback. Ejecútalo una vez de verdad. Si te lleva diez minutos de torpeza, lo que hay que arreglar es eso, no la rampa.
Si tu proyecto todavía está en la fase de averiguar quién lo va a pagar, esto probablemente es prematuro. Publica de forma sencilla, guarda un script de rollback y vuelve a los canarios cuando una caída te costaría clientes de verdad. Si ya estás ahí, la ruta con pesos más una regla de aborto son un fin de semana de trabajo, y se paga solo la primera vez que una mala versión muere al 1% en lugar de al 100%.
¿Hay que hacer canary de todo?
No. Los cambios de configuración, los retoques de texto y las erratas en un pie de página no necesitan rampa. Usa canarios para los cambios en los que equivocarse cuesta dinero o confianza: pagos, autenticación, modelos de datos y cualquier cosa en la ruta crítica. Una cadena que sube la rampa en cada commit durante una hora acabará saltándose la primera vez que alguien tenga prisa, y un proceso que se salta es peor que no tener proceso.
Entonces, ¿cuál es el cambio más arriesgado de tu próxima publicación, y qué haría falta para enviarlo primero al 1% de los usuarios?