Monorepo vs Polyrepo : le choix de stack qui s'impose
Résumé
Pour la plupart des devs solo qui construisent un produit avec des packages partagés, monorepo est le bon défaut en 2026. Ce guide explique ce que tu gagnes vraiment au-delà du pitch théorique, quand polyrepo gagne vraiment, quels coûts CI attendre, et comment les outils de coding IA comme Cursor et Claude Code ont modifié les équilibres classiques. Plus trois signaux concrets qui te disent qu'il est temps de splitter en repos séparés.
La question monorepo vs polyrepo remonte avant chaque nouveau projet, et la réponse façonne des mois de setup CI/CD, de refactoring, et de contrôle d'accès. Pour la plupart des devs solo qui construisent un produit avec du code partagé, le bon défaut en 2026 est monorepo. Pas parce que c'est le choix trendy, mais parce qu'il élimine la cérémonie de publication que les polyrepos imposent au moment où deux packages ont besoin de se parler. Si tes services sont vraiment indépendants et ne partageront jamais de code, polyrepo est plus simple. Dans tous les autres cas, c'est du contexte.
Il est 22h. T'as un nouveau projet qui prend forme : une API backend, un package de types TypeScript partagés, et un dashboard frontend qui consommera forcément les deux. Deux tabs ouvertes. Le curseur clignote.
La plupart des posts sur le sujet sont écrits pour des équipes de vingt devs avec un DevOps dédié qui aime configurer Bazel. Celui-ci est pour ceux qui doivent trancher avant le premier commit, parce que restructurer six mois après, quand tu as des vrais users et un pipeline CI que tu maîtrises d'instinct, c'est le genre de truc qui tue un side project sans retour.
Ce qu'un monorepo te donne vraiment (pas la version livre)
Le pitch standard c'est « un repo, dépendances partagées, atomic changes ». C'est tout réel. Mais ce qui compte vraiment jour après jour pour un builder solo, c'est plus concret : tu n'as pas à publier des packages pour les utiliser localement.
Dans une setup polyrepo, si shared-utils a besoin d'un fix qui touche aussi api-service, soit tu publies une nouvelle version de shared-utils, tu bumps la dépendance dans api-service, tu attends le CI, puis tu déploies. Soit tu fais des hacks npm link qui marchent jusqu'à ce qu'ils ne marchent plus au milieu d'un sprint. Dans un monorepo avec des workspaces, tu changes le code, et chaque package qui l'importe voit le changement tout de suite. Pas de cérémonie de publication.
Voilà ce que ça donne avec pnpm workspaces, qui ajoute un minimum de config :
/packages
  /shared-types      ← importé directement par api et web
  /api
  /web
package.json         ← workspace root avec champ "workspaces"
// api/package.json
{
"dependencies": {
"@myapp/shared-types": "workspace:*"
}
}Pas de publication. Pas de version bump en dev. workspace:* résout le package local, et les project references TypeScript te donnent une compilation incrémentale sur tout le graphe.
Le deuxième vrai bénéfice : le refactoring cross-package qui atterrit en une PR. Tu renommes une interface dans shared-types ? TypeScript te dit chaque consumer qui a cassé, dans le même codebase, dans la même session d'éditeur. En polyrepo, tu la renommes dans repo A, tu publies une nouvelle version, et tu découvres le bris dans repo B trois jours après quand un collègue run npm install et que les types ne matchent pas le runtime.
Le troisième bénéfice, que les devs solo sous-estiment : une place pour la tooling config. Un .eslintrc, un prettier.config.js, un seul fichier CI workflow. Petits gains par changement, mais ça s'accumule sur des mois d'itération.
Il est utile de dire ce qu'un monorepo ne te donne pas : il n'élimine pas le couplage entre services. Si tes services sont vraiment indépendants et que tu les mets quand même dans un monorepo, t'as ajouté de la coordination sans retour. Les bénéfices du monorepo se matérialisent seulement quand les services partagent vraiment du code ou ont besoin de changer ensemble. La structure du repo doit refléter la structure des dépendances, pas l'imposer.
Quand polyrepo se justifie vraiment
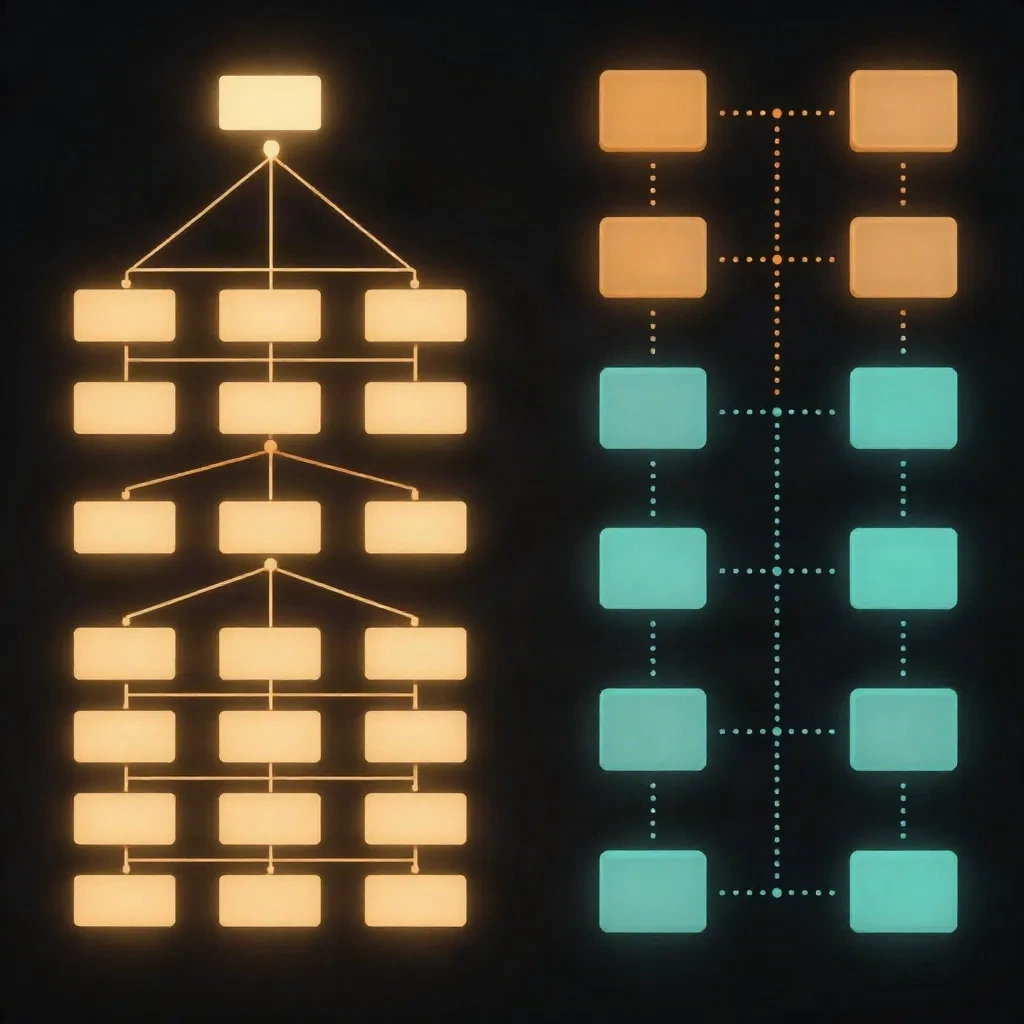
Polyrepo n'est pas une erreur. C'est le bon choix pour des situations précises, et prétendre le contraire, c'est comment tu finiras avec un monorepo de 40 services qui prend 25 minutes à cloner.
Le cas le plus clair : services avec vraiment un ownership différent, des cycles de release différents, ou des exigences de compliance différentes. Si ton service de billing est PCI-scoped et ton site marketing ne l'est pas, garder chacun dans son repo, c'est garder le contrôle d'accès, les audit logs, et le blast radius clean et séparé. C'est pas de la friction opérationnelle. C'est la feature.
Polyrepo gagne aussi quand tu open-sources une partie du codebase. Un repo public dédié te laisse les contributeurs externes fork et PR sans pull ton infra privée en scope. Le modèle de permissions par repository de GitHub ne te donne pas une isolation d'accès par paths à l'échelle. Un repo séparé gère ça correctement.
Et pour du pure microservices avec des tech stacks carrément différents : un service Go et une app React Native qui ne partagent littéralement rien au niveau code, monorepo ajoute du coût de coordination sans livrer le bénéfice. S'il n'y a pas de packages partagés, il n'y a rien à partager.
La version honnête de ça : la plupart des indie projects qui commencent en polyrepo finissent par le regretter, pas parce que polyrepo est une mauvaise architecture, mais parce qu'ils ont surestimé l'indépendance des parties. Le frontend finit toujours par avoir besoin d'un type du backend. Le worker finit toujours par avoir besoin d'une utility de l'API. Deux repos deviennent quatre PRs par feature.
Le coût CI/CD que personne ne mentionne jusqu'à ce qu'il frappe ta facture
Les monorepos ont un vrai coût opérationnel : si ton CI run naïvement tout sur chaque commit, tu pales en temps et en money pour des builds et des tests qui n'ont rien à voir avec ce que t'as changé.
T'as pushé un tweak CSS au package web. CI run la full test suite pour api, worker, et shared-types. C'est six minutes de GitHub Actions compute pour une couleur. À l'échelle, ça crée des queues CI qui bloquent toute l'équipe.
La solution existe, mais elle demande du setup intentionnel : des outils d'orchestration de build qui comprennent ton graphe de dépendances. Turborepo et Nx résolvent ça tous les deux. Le turbo.json de Turborepo définit un pipeline où chaque tâche run seulement pour les packages avec des inputs changés :
{
  "pipeline": {
    "build": {
      "dependsOn": ["^build"],
      "outputs": ["dist/**"]
    },
    "test": {
      "dependsOn": ["build"],
      "cache": true
    }
  }
}
Avec le remote caching activé (gratuit sur Turborepo Cloud tier Vercel pour les petites équipes), un cache hit sur un package inchangé est instantané, pas de rebuild, pas de retest. Pour un dev solo sur un side project, ça tient le CI sous deux minutes sur la plupart des pushes une fois que les build artifacts sont warm.
Le coût : faut que tu apprennes Turborepo ou Nx avant d'en avoir besoin, pas après. C'est à peu près une demi-journée de setup. Si tu skip ça et laisse le CI grossir, le monorepo CI va ralentir au point où tu vas commencer à remettre en question tout le choix architectural, et c'est typiquement quand les devs décident que polyrepo avait raison, alors que le vrai problème était juste un fichier config manquant.
Comment les outils IA ont changé l'équilibre du débat
Jusqu'à récemment, un argument vrai pour polyrepo était la charge cognitive : les petits repos sont plus faciles à raisonner parce qu'ils sont isolés. Tu context-switch sur un service nouveau, tu vois juste ce qui est pertinent pour ce service. L'argument était légitime.
Les outils de coding IA changent le calcul. Quand tu travailles avec Cursor, Claude Code, ou GitHub Copilot, l'outil travaille avec ton codebase complet en contexte. Il voit les dépendances cross-service, comprend quelle interface est consommée par quel service, et peut tracker un champ renommé à travers chaque consumer sans que tu tiennes le mental model toi-même. L'argument « le petit repo isolé est plus facile à comprendre » s'affaiblit beaucoup quand ton assistant IA tient tout le graphe de dépendances en contexte de toute façon.
Un exemple concret : en setup polyrepo, si tu demandes à un assistant IA de refactorer un endpoint API qui affecte aussi un type partagé, typiquement il ne peut pas voir les deux repos en une session. T'es en train de faire la coordination manuellement, c'est exactement la friction qu'un monorepo était supposé éliminer. En monorepo, le même refactor c'est une conversation.
Ca ne flip pas la décision complètement. Mais ça retire une des justifications historiques pour polyrepo pour les petites équipes et les devs solo, et ça penche le défaut un peu plus vers monorepo quand le code est vraiment couplé.
Trois signaux que tu dois splitter le repo maintenant
T'as commencé avec un monorepo. Bien. Mais voici les signaux concrets que le split est devenu le bon appel :
Le contrôle d'accès devient critical. Un contractor a besoin d'accès frontend, pas backend. Une équipe d'intégration partner a besoin de lire ton API schema mais rien de propriétaire. Le Codeowners de GitHub peut limiter qui peut review quels paths, mais ça ne limite pas l'accès en lecture. Si l'isolation de lecture compte pour compliance ou security, les repos séparés sont la réponse clean. Les gymnastics Codeowners ne remplacent jamais complètement les permissions au niveau repository.
Les fails CI dans un service bloquent le déploiement dans un autre. Si un broken test dans payment-service gate un hotfix que tu dois ship dans marketing-site, ton monorepo crée un couplage que ton codebase n'a pas. Soit la config de build a besoin de fix (task scoping avec Turborepo va résoudre ça), soit les deux services n'appartiennent vraiment pas au même repo.
Une partie va open-source et une non. C'est le cas de split le plus clean. Extract la pièce open-source dans son propre repo public. Du code mixed public/private dans un monorepo GitHub est vraiment douloureux : tu aurais besoin d'une organization séparée ou d'un process de pruning manuel qui crée une maintenance overhead permanente.
La setup pratique où la plupart des builders se retrouvent
La réponse où la plupart des devs expérimentés se stabilisent : un monorepo par product domain, pas « un monorepo pour tout ce que t'as jamais construit » et pas « un repo par package ».
Si tu construis une SaaS avec un frontend web, une API, et une shared type library, c'est un produit. Garde ça dans un monorepo. Si tu maintiens aussi une CLI utility open-source que d'autres projets utilisent, c'est un repo différent avec une audience et un cycle de release différents.
L'erreur c'est de traiter le choix monorepo/polyrepo comme idéologique. C'est pas « les équipes monorepo » versus « les équipes polyrepo ». C'est une décision structurelle basée sur trois questions : quel est le graphe de dépendances entre tes services ? Qui a besoin d'accès à quoi, et est-ce que l'isolation compte ? Quelle est ta tolérance pour la complexité du setup CI/CD ?
Pour les side projects spécifiquement : commence avec un monorepo utilisant pnpm workspaces (npm workspaces marche aussi, juste moins ergonomic). Ajoute Turborepo seulement quand ton CI commence régulièrement à frapper 4+ minutes. Splitte en un repo séparé seulement quand t'as une raison concrète : open-source, contrôle d'accès, compliance, ou une équipe partner avec un cycle de release différent. Pas parce que ça semble plus architecturalement clean.
Le débat monorepo vs polyrepo est un de ces choix où la bonne réponse pour la plupart des devs solo est pareille : commence simple, optimise quand la friction spécifique apparaît. Le curseur clignote toujours. Ship le premier commit.