Monorepo vs Polyrepo: la scelta di architettura che conta
Riassunto
Per la maggior parte degli sviluppatori indie che costruiscono un prodotto con package condivisi, un monorepo è la scelta giusta nel 2026. Questa guida spiega cosa guadagni davvero oltre la teoria, quando il polyrepo vince, quali costi aspettarsi da CI/CD, e come gli strumenti AI come Cursor e Claude Code hanno cambiato i trade-off classici. Più tre segnali concreti che ti dicono quando è arrivato il momento di separare i repo.
La domanda monorepo vs polyrepo emerge prima di ogni nuovo progetto, e la risposta modella settimane di configurazione CI/CD, overhead di refactoring, e controllo di accesso ai team. Per la maggior parte degli sviluppatori indie che costruiscono un prodotto con codice condiviso, la scelta giusta nel 2026 è il monorepo. Non perché è la tendenza del momento, ma perché elimina la cerimonia di pubblicazione che i polyrepo impongono nel momento in cui due package devono comunicare. Se i tuoi servizi sono completamente indipendenti e non condivideranno mai codice, il polyrepo è più semplice. Ogni altro caso è contesto, e il contesto è quello di cui parleremo qui.
Sono le 22. Hai un nuovo progetto che ha senso: un backend API ben strutturato, un package di tipi TypeScript condivisi che il frontend richiede, e un frontend dashboard che inevitabilmente consumerà entrambi plus una libreria di utilità comuni. Due tab aperti. Il cursore lampeggia. La decisione che prendi nelle prossime due ore influenzerà come lavorerai sui prossimi sei mesi.
La maggior parte dei post su questo argomento è scritta per team di venti persone con un DevOps engineer dedicato che ama configurare Bazel e leggere documentazione di Kotlin. Questo articolo è per i builder che devono prendere la decisione prima del primo commit, perché ristrutturare sei mesi dopo, quando hai utenti reali in produzione, una pipeline CI che conosci a memoria, e feature in volo, è il genere di cosa che uccide il momentum di un side project per sempre. Non è una migrazione senza rischi, e non dovrebbe diventare il tuo problema se era evitabile al primo commit.
Cosa ti dà davvero un monorepo (non la versione da manuale)
La presentazione standard è "un repo, dipendenze condivise, cambiamenti atomici". Tutto vero. Ma la parte che conta davvero giorno per giorno per uno sviluppatore solo è più concreta: non devi pubblicare package per usarli localmente.
In un setup polyrepo, se shared-utils ha un bug che riguarda anche api-service, o pubblichi una nuova versione di shared-utils, aggiorni la dipendenza in api-service, aspetti che la CI passi, e poi fai il deploy. Oppure ricorri agli hack di npm link che funzionano fino a quando non smettono di farlo nel mezzo di uno sprint. In un monorepo con workspace, cambi il codice, e ogni package che lo importa vede il cambiamento subito. Niente cerimonie.
Ecco cosa assomiglia con pnpm workspace, che aggiunge un overhead di configurazione minimo:
/packages
  /shared-types      <- importato direttamente da api e web
  /api
  /web
package.json         <- radice workspace con il campo workspaces
{
"dependencies": {
"@myapp/shared-types": "workspace:*"
}
}Nessuna pubblicazione. Nessun bump di versione durante lo sviluppo. workspace:* si risolve al package locale, e i project reference di TypeScript ti danno compilazione incrementale su tutto il grafo. Il tuo editor capisce il cambiamento istantaneamente, le tue test locali vedono il codice nuovo, e non c'è mai quella fase di pubblicazione che genera confusione tra lo stato del filesystem e quello del package manager.
Il secondo vantaggio reale: refactoring cross-package che arriva in un PR. Rinomini un'interfaccia in shared-types? TypeScript ti dice ogni consumer che si è rotto, nello stesso codebase, nella stessa sessione dell'editor. Puoi fare refactor globali e vedere esattamente cosa si rompe prima di commitare. In un polyrepo, la rinomini nel repo A, pubblichi una nuova versione con un numero di versione nuovo, aggiorni il lockfile del repo B, e poi scopri il danno tre giorni dopo quando un collega fa npm install e i tipi non corrispondono più al runtime. Questo non accade in un monorepo.
Il terzo vantaggio, che gli sviluppatori solo sottovalutano: un solo posto per la configurazione degli strumenti. Un .eslintrc, un prettier.config.js, un workflow CI. Piccoli risparmi per ogni cambio, ma si accumulano in mesi di iterazione. Quando migliori linting o formatting, migliori per tutto il monorepo contemporaneamente.
Vale la pena nominare cosa un monorepo NON ti dà: non riduce l'accoppiamento tra servizi. Se i tuoi servizi sono davvero indipendenti e li metti comunque in un monorepo, hai aggiunto overhead di coordinamento senza ritorno. I vantaggi del monorepo si materializzano solo quando i servizi condividono davvero codice o devono cambiare insieme. La struttura del repo dovrebbe riflettere la struttura di dipendenza, non imporla.
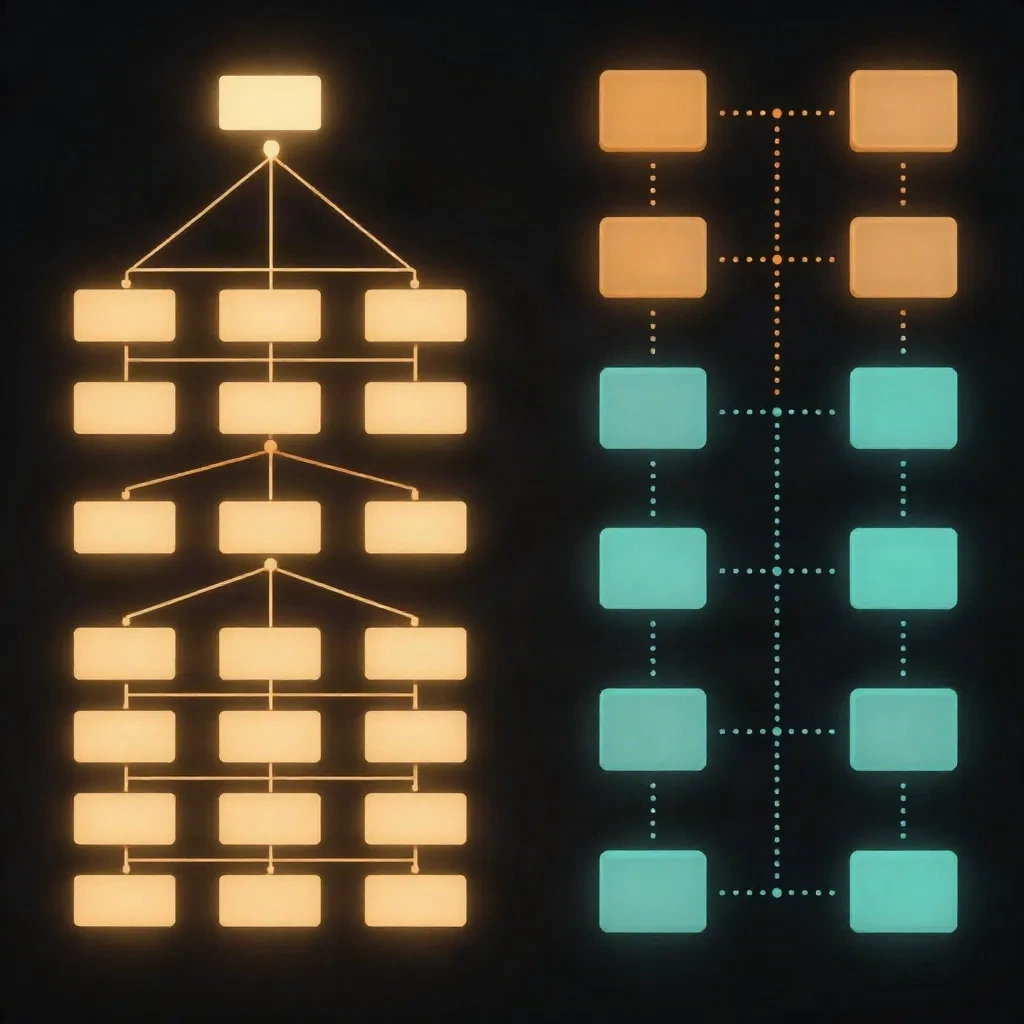
Quando il polyrepo merita davvero il suo posto
Il polyrepo non è un errore. È la scelta giusta per situazioni specifiche, e fingere il contrario è come finire con un monorepo di 40 servizi che impiega 25 minuti a fare il clone.
Il caso più chiaro: servizi con ownership, release cycle, o compliance requirement davvero diversi. Se il tuo servizio di billing è in scope PCI e il tuo marketing site no, tenere i repo separati significa mantenere il controllo d'accesso, i log di audit, e il blast radius pulitamente separati. Quello non è overhead operativo. È la feature.
Il polyrepo vince anche quando fai open-source di parte del tuo codebase. Un repo pubblico dedicato lascia ai contributor esterni il fork e il PR senza tirare la tua infrastruttura privata in scope. Il modello di permessi di GitHub a livello repository non ti dà isolamento di accesso pulito basato su path a scala. Un repo separato lo gestisce correttamente.
E per microservizi puri con stack tecnologici completamente distinti: un servizio Go e un'app React Native che letteralmente non condividono niente a livello di codice, un monorepo aggiunge costo di coordinamento senza il beneficio. Se non ci sono package condivisi, non c'è niente da condividere.
La versione onesta: la maggior parte dei progetti indie che partono con un polyrepo finisce per pentirsene, non perché il polyrepo è una cattiva architettura, ma perché hanno sovrastimato quanto indipendenti resterebbero le parti. Il frontend ha sempre bisogno di un tipo dal backend. Il worker ha sempre bisogno di un utility dall'API. Due repo diventano quattro PR per ogni feature.
Il costo di CI/CD che nessuno menziona fino a quando non colpisce la fattura
I monorepo hanno un costo operativo reale: se la tua CI ingenuamente esegue tutto ad ogni commit, paghi in tempo e soldi per build e test che non hanno nulla a che fare con quello che hai cambiato. Questo è il trap più comune nei monorepo, e quello che converte i developer da entusiasti a scettici in circa tre mesi.
Push un aggiustamento CSS al package web. La CI esegue la suite di test completa per api, worker, e shared-types. Sei minuti di compute su GitHub Actions per un cambio di colore. A scala con venti developer che fanno push al giorno, questo diventa code di CI che bloccano tutto il team e fatture di GitHub Actions che non riuscite a spiegare.
La soluzione esiste, ma richiede setup deliberato: strumenti di build orchestration che capiscono il tuo grafo di dipendenza. Turborepo e Nx risolvono entrambi questo. Il turbo.json di Turborepo definisce una pipeline dove ogni task esegue solo per i package con input cambiati:
{
  "pipeline": {
    "build": {
      "dependsOn": ["^build"],
      "outputs": ["dist/**"]
    },
    "test": {
      "dependsOn": ["build"],
      "cache": true
    }
  }
}
Con il caching remoto abilitato (gratuito sul tier di Vercel Turborepo Cloud per piccoli team), un cache hit su un package non modificato è istantaneo, niente rebuild, niente retest. Per uno sviluppatore solo su un side project, questo mantiene la CI sotto due minuti sulla maggior parte dei push una volta che gli artefatti di build sono caldi.
Il costo di apprendimento: devi imparare Turborepo o Nx prima di averne davvero bisogno, non dopo che il problema è diventato critico. Sono circa mezza giornata di setup, più un giorno di debug se sbagli la configurazione della pipeline la prima volta. Se lo salti e lasci che la CI accumuli massa, il monorepo CI rallenterà al punto dove cominci a questionare tutta la scelta architettonica, e di solito è esattamente quando i developer decidono che il polyrepo aveva ragione dal principio, quando il vero problema era solo un file di configurazione mancante.
Come gli strumenti di coding AI hanno cambiato la matematica di questo dibattito
Fino a poco fa, un argomento genuino per il polyrepo era il cognitive load: repo più piccoli sono più facili da ragionare perché isolati. Context-switch a un nuovo servizio, vedi solo quello che è rilevante per quel servizio. L'argomento era legittimo.
Gli strumenti di coding AI cambiano il calcolo. Quando lavori con Cursor, Claude Code, o GitHub Copilot, lo strumento lavora con il tuo codebase completo in context window. Vede le dipendenze cross-service, capisce quale interfaccia è consumata da quale servizio, e può tracciare un campo rinominato attraverso ogni consumer in una conversazione. L'argomento "repo isolato è più facile da capire" si indebolisce significativamente quando il tuo assistente AI mantiene il grafo di dipendenza intero comunque.
Un esempio concreto: in un setup polyrepo, se chiedi a un assistente AI di refactorisare un endpoint API che influenza anche un tipo condiviso, di solito non può vedere entrambi i repo in una sessione. Stai facendo il coordinamento manualmente, che è esattamente l'overhead che un monorepo dovrebbe eliminare. In un monorepo, lo stesso refactor è una conversazione unica.
Questo non capovolge la decisione interamente. Ma rimuove una delle giustificazioni storiche per il polyrepo per piccoli team e sviluppatori solo, e inclina leggermente il default verso il monorepo quando il codice è davvero accoppiato.
Tre segnali che significano che devi separare il repo adesso
Sei partito con un monorepo. Bene. Ma ecco i segnali concreti che la separazione è diventata la scelta giusta:
Il controllo d'accesso sta diventando critico. Un contractor ha bisogno di accesso frontend, non backend. Un team di integrazione partner deve leggere il tuo schema API ma nulla di proprietario. I Codeowners di GitHub possono limitare chi può fare review su quali path, ma non limitano l'accesso in lettura. Se l'isolamento di lettura conta per compliance o sicurezza, repo separati sono la risposta pulita. Non è un acrobatismo, è la soluzione corretta.
I fallimenti di CI in un servizio stanno bloccando il deploy in uno non correlato. Se un test rotto in payment-service sta bloccando un hotfix che devi shipped in marketing-site, il tuo monorepo sta creando accoppiamento che il tuo codebase non ha. O la configurazione di build ha bisogno di essere fixata (lo scoping di task con Turborepo lo risolverà), oppure i due servizi genuinamente non appartengono allo stesso repo.
Una parte sta andando open-source e l'altra no. Questo è il caso di split più pulito. Estrai il pezzo open-source nel suo repo pubblico dedicato. Codice misto pubblico/privato in un monorepo GitHub è genuinamente doloroso: avresti bisogno di un'organizzazione separata o di un processo di pruning manuale che crea overhead di manutenzione permanente.
Il setup pratico su cui la maggior parte dei builder atterra
La risposta su cui i developer esperti si stabilizzano: un monorepo per dominio di prodotto, non "un monorepo per tutto quello che hai mai costruito" e non "un repo per ogni package".
Se stai costruendo un SaaS con un frontend web, un'API, e una libreria di tipi condivisi, quello è un prodotto. Tienilo in un monorepo. Se mantieni anche un utility CLI open-source che altri progetti usano, quello è un repo diverso con un pubblico diverso e un release cycle diverso.
L'errore più comune è trattare la scelta monorepo/polyrepo come ideologica, come se fosse una dichiarazione sulla filosofia di ingegneria software. Non è così. Non è "team di monorepo" contro "team di polyrepo". È una decisione strutturale pragmatica basata su tre domande concrete: qual è il differenza monorepo polyrepo in termini di dipendenza tra i tuoi servizi, e quali parti cambiano insieme? Chi ha bisogno di leggere e modificare cosa, e l'isolamento di accesso conta davvero per conformità o sicurezza? Quale è la tua tolleranza personale per la complessità di setup CI/CD, e quanto tempo vuoi spendere su infrastruttura versus feature?
Per i side project nello specifico: inizia con un monorepo usando pnpm workspace (npm workspace funziona anche, solo meno ergonomico). Aggiungi Turborepo solo quando la tua CI inizia regolarmente a superare 4 minuti. Separa in un repo diverso solo quando hai una ragione concreta: open-source, controllo d'accesso, compliance, o un team partner con release cadence diverso. Non perché sembra architettonicamente più pulito.
Il dibattito monorepo vs polyrepo è una di quelle scelte dove la risposta giusta per la maggior parte degli sviluppatori indie è la stessa: inizia semplice, ottimizza quando l'attrito specifico appare. Il cursore sta ancora lampeggiando. Fai il primo commit.