Monorepo vs polyrepo: architektura którą buildujesz
Summary
Dla większości solo developerów budujących produkt ze wspólnymi pakietami, monorepo to słuszny domyślny wybór w 2026. Ten poradnik wyjaśnia, co naprawdę zyskujesz poza marketingowym bla-bla, kiedy polyrepo rzeczywiście wygrywa, jakie koszty CI/CD warto liczyć i jak narzędzia AI jak Cursor czy Claude Code zmieniły klasyczne dylematy. Plus trzy konkretne sygnały, które mówią Ci, że czas podzielić się na osobne repozytoria.
Pytanie o monorepo vs polyrepo pojawia się przed każdym nowym projektem i odpowiedź kształtuje miesiące konfiguracji CI/CD, refaktoringu i kontroli dostępu. Dla większości solo developerów budujących produkt ze wspólnym kodem, słusznym domyślnym wyborem w 2026 jest monorepo. Nie dlatego, że to modny wybór, ale dlatego że eliminuje ceremonię publikacji, którą polyrepo nakłada w momencie, gdy dwa pakiety muszą się ze sobą komunikować. Jeśli Twoje usługi są całkowicie niezależne i nigdy naprawdę nie będą dzielić kodu, polyrepo jest prostsze i bardziej przejrzyste. W każdym innym przypadku to kwestia konkretnego kontekstu Twojego projektu.
Jest 22 w nocy. Pracujesz nad nowym projektem: backend API, pakiet wspólnych TypeScript types, i dashboard frontendowy, który oczywiście będzie konsumować oba. Dwie zakładki otwarte. Kursor miga.
Więcej artykułów na ten temat to artykuły napisane dla zespołów dwudziestu osób z dedykowanym DevOpsem, który uwielbia konfigurować Bazel i ma czas na eksperymentowanie. Ten tekst jest dla builderów, którzy muszą podjąć decyzję przed pierwszym commitem, bo przestrukturyzowanie za sześć miesięcy, kiedy masz prawdziwych użytkowników i CI pipeline, który Twoje mięśnie już pamiętają, to coś, co zabija momentum side projectu na stałe i utrudnia dodawanie nowych features.
Co monorepo naprawdę Ci daje (nie w wersji podręcznikowej)
Standardowy pitch to "jedno repozytorium, wspólne dependencje, atomowe zmiany". To wszystko prawda. Ale to, co naprawdę się liczy dzień po dniu dla solo buildera, to coś bardziej konkretnego: nie musisz publikować pakietów żeby ich używać lokalnie.
W setupie polyrepo, jeśli shared-utils potrzebuje naprawy, którą musi też wprowadzić api-service, albo publikujesz nową wersję shared-utils, updateujesz dependency w api-service, czekasz aż CI przejdzie, i wtedy deployujesz. Albo sięgasz po npm link hacki, które działają dopóki przestają działać w środku sprintu. W monorepo z workspaces zmieniasz kod i każdy pakiet, który go importuje, widzi zmianę natychmiast. Żadna ceremonia publikacji.
Tak to wygląda z pnpm workspaces, które dodają minimalny overhead konfiguracji:
/packages
  /shared-types      ← importowane bezpośrednio przez api i web
  /api
  /web
package.json         ← workspace root z polem "workspaces"
// api/package.json
{
"dependencies": {
"@myapp/shared-types": "workspace:*"
}
}Bez publikacji. Bez bumpu wersji podczas developmentu. workspace:* rozwiązuje się do pakietu lokalnego, a TypeScript project references daje Ci kompilację inkrementalną na całym grafie.
Druga rzeczywista zaleta: refaktoryzacja cross-package, która ląduje w jednym PR. Przeimenowujesz interfejs w shared-types? TypeScript mówi Ci o każdym konsumencie, który się złamał, w tym samym codebase, w tym samym oknie edytora. W polyrepo przeimenowujesz w repo A, publikujesz nową wersję, a dzień później kolega z zespołu uruchamia npm install i odkrywa, że types nie pasują do runtime.
Trzecia zaleta, którą solo developerzy niedoceniają: jedno miejsce na konfigurację toolingu. Jeden .eslintrc, jeden prettier.config.js, jeden workflow file CI. Małe oszczędności per zmiana, ale się sumują przez miesiące iteracji.
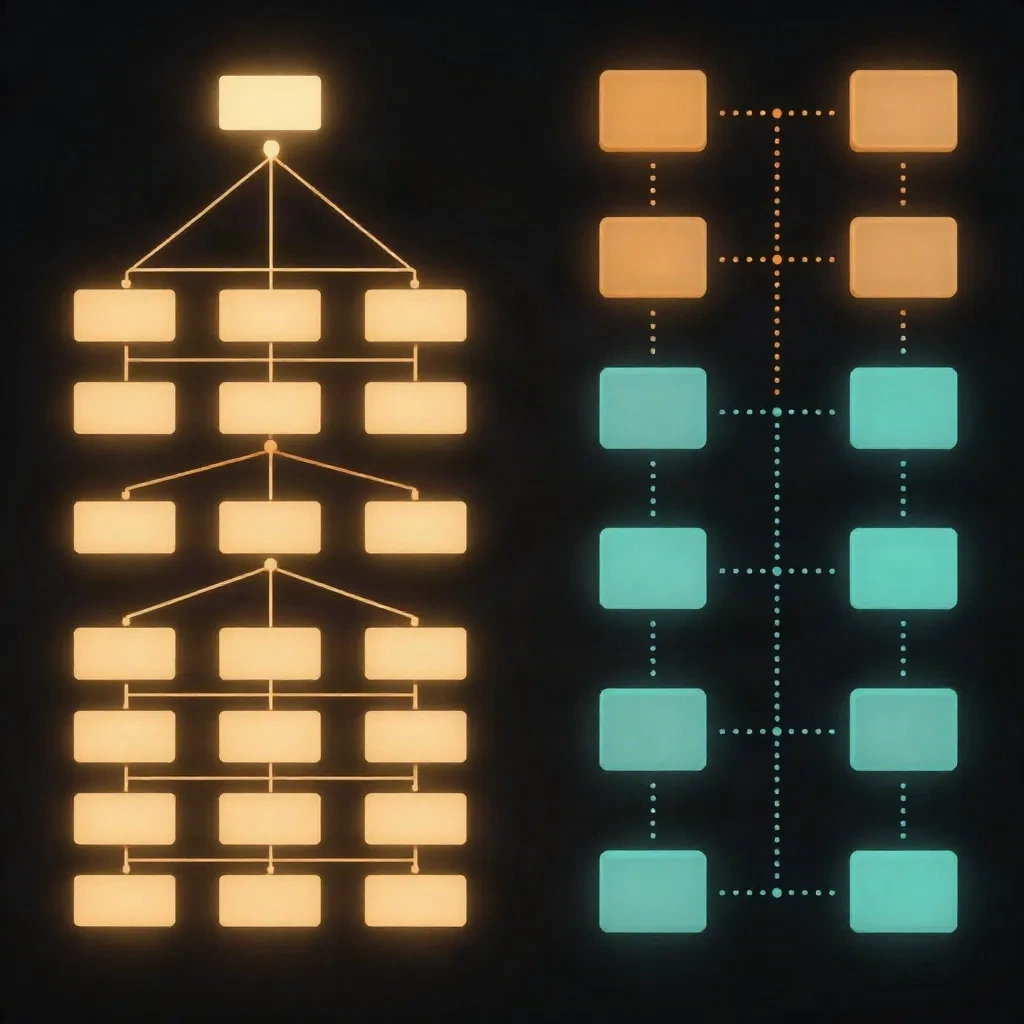
Warto nazwać to, czego monorepo NIE daje: nie czyni usług mniej skuplowanymi. Jeśli Twoje usługi są naprawdę niezależne i umieścisz je w monorepo mimo to, dodajesz overhead koordynacji bez zwrotu. Zalety monorepo materializują się tylko wtedy, gdy usługi rzeczywiście dzielą kod lub muszą się zmieniać razem. Struktura repo powinna odzwierciedlać strukturę dependencji, nie jej narzucać.
Kiedy polyrepo rzeczywiście wygrywa
Polyrepo nie jest błędem. To słuszny wybór dla specyficznych sytuacji, a udawanie inaczej to droga do 40-service monorepo, które klonuje się 25 minut.
Najwyraźniejsza sytuacja: usługi z rzeczywiście różnym ownership, release cyclem lub wymaganiami compliance. Jeśli Twoja usługa billingowa jest PCI-scoped a strona marketingowa nie, trzymanie ich w osobnych repo oznacza czysty podział access control, audit logs i blast radius. To nie overhead operacyjny. To funkcja.
Polyrepo też wygrywa kiedy open-sourcujesz część codebase. Dedykowane publiczne repo pozwala zewnętrznym contributorom forkować i robić PR bez ściągania Twojej prywatnej infrastruktury. Model uprawnień GitHub na poziomie repo nie daje Ci czystej izolacji dostępu na poziomie ścieżek w skali. Osobne repo rozwiązuje to prawidłowo.
I dla czystych microservices z całkowicie różnymi tech stackami: usługa Go i React Native app, które dosłownie nic nie dzielą na poziomie kodu, monorepo dodaje koszt koordynacji bez dostarczając benefitu. Jeśli nie ma wspólnych pakietów, nie ma czego dzielić.
Honestna wersja: większość indie projektów, które zaczynają z polyrepo, żałuje tego, nie dlatego że polyrepo to zła architektura, ale dlatego że przeszacowali, jak niezależne będą części. Frontend zawsze potrzebuje typu z backendu. Worker zawsze potrzebuje utility z API. Dwa repo stają się cztery PR-y na feature.
Koszt CI/CD, o którym nikt nie mówi aż do faktury
Monorepo mają rzeczywisty koszt operacyjny: jeśli Twój CI naiwnie uruchamia wszystko na każdy commit, płacisz czasem i pieniędzmi za buildy i testy, które mają nic wspólnego z tym co zmieniłeś.
Pushasz tweak CSS do web package. CI uruchamia pełny test suite dla api, worker i shared-types. To sześć minut GitHub Actions compute za zmianę koloru. W skali to są CI queues, które blokują cały zespół.
Rozwiązanie istnieje, ale wymaga celowego setupu: narzędzia build orchestration, które rozumieją Twój dependency graph. Turborepo i Nx oba to rozwiązują. turbo.json Turborepo definiuje pipeline gdzie każdy task uruchamia się tylko dla packageów ze zmienionymi inputami:
{
  "pipeline": {
    "build": {
      "dependsOn": ["^build"],
      "outputs": ["dist/**"]
    },
    "test": {
      "dependsOn": ["build"],
      "cache": true
    }
  }
}
Z remote cachingiem włączonym (darmowy Vercel Turborepo Cloud tier dla małych zespołów), cache hit na niezmieniony package to moment, no rebuild, no retest. Dla solo devs na side project, to trzyma CI poniżej dwóch minut na większości pushów kiedy build artifacts są ciepłe.
Koszt: musisz poznać Turborepo albo Nx zanim będziesz go potrzebować, nie potem. To mniej więcej pół dnia setupu. Jeśli to pominiesz i pozwolisz CI rosnąć w tłuszcz, monorepo CI zwalnia do punktu gdzie zaczynasz kwestionować całą architekturalną decyzję, i to zwykle wtedy kiedy developerzy decydują że polyrepo było słusznym wyborem, kiedy rzeczywisty problem to była tylko brakująca linia konfiguracji.
Jak narzędzia AI zmieniły matematykę tej debaty
Do niedawna jeden rzeczywisty argument za polyrepo to cognitive load: mniejsze repo są łatwiejsze do zrozumienia bo są izolowane. Context-switch do nowej usługi, widzisz tylko to co jest relevantne dla tej usługi. Argument był uzasadniony.
Narzędzia AI do codingu przesuwają tę kalkulację. Kiedy pracujesz z Cursor, Claude Code czy GitHub Copilot, narzędzie pracuje z pełnym twoim codebase w kontekście. Widzi cross-service dependencje, rozumie który interfejs jest konsumowany przez którą usługę i może śledzić przeimieniowanie pola przez każdego konsumenta bez trzymania całej mentalnej mapy. Argument "izolowane repo jest łatwiejsze do zrozumienia" słabnie znacznie kiedy Twój AI asystent trzyma cały dependency graph w kontekście.
Konkretny przykład: w setupie polyrepo, jeśli poprosisz AI asystenta o refaktoryzację API endpointa, która też wpływa na wspólny type, zazwyczaj nie widzi obu repo w jednej sesji. Robisz koordynację ręcznie, co jest dokładnie overheadem, który monorepo miał wyeliminować. W monorepo to jest jedna konwersacja.
To nie całkowicie zmienia decyzję. Ale usuwa jedno z historycznych uzasadnień dla polyrepo dla małych zespołów i solo developerów, i przechyla default trochę bardziej w stronę monorepo kiedy kod jest naprawdę skupiony.
Trzy sygnały że powinno się podzielić repo teraz
Zacząłeś z monorepo. Dobrze. Ale tu są konkretne sygnały że podzielenie się stało słusznym wyborem:
Kontrola dostępu staje się krityczna. Contractor potrzebuje dostępu do frontend, nie backend. Partner integration team potrzebuje czytać Twój API schema ale nic proprietary. GitHub Codeowners może ograniczyć kto może reviewować które ścieżki, ale nie ogranicza read access. Jeśli izolacja read jest ważna dla compliance czy security, osobne repo to czysty answer. Codeowners akrobacje nigdy w pełni nie zastępują uprawnień na poziomie repo.
CI failury w jednej usłudze blokują deployment w niezwiązanej. Jeśli broken test w payment-service gateuje hotfiks który musisz shipować w marketing-site, Twój monorepo tworzy coupling które Twój codebase nie ma. Albo build configuration potrzebuje naprawy (task scoping z Turborepo rozwiąże to), albo dwie usługi naprawdę nie należą do tego samego repo.
Jedna część idzie open-source a druga nie. To najczystszy split case. Wyciągnij open-source piece do własnego publicznego repo. Mixed public/private kod w GitHub monorepo to naprawdę painful: byś potrzebował osobną organizację albo manual pruning process co tworzy permanentny maintenance overhead.
Praktyczny setup gdzie lądują większość builderów
Odpowiedź na którą ląduje większość doświadczonych developerów: jedno monorepo per product domain, nie "jedno monorepo na wszystko co kiedykolwiek buildujesz" i nie "jedno repo per package".
Jeśli buildujesz SaaS z web frontend, API i shared type library, to jeden produkt. Trzymaj to w jednym monorepo. Jeśli też utrzymujesz open-source CLI utility które inne projekty używają, to różne repo z różnym audience i release cycle.
Błąd to traktowanie monorepo/polyrepo wyboru jako ideologicznego. To nie "monorepo teams" versus "polyrepo teams". To decyzja strukturalna bazowana na trzech pytaniach: Jaki jest dependency graph między Twoimi usługami? Kto potrzebuje dostępu do czego i czy izolacja ma znaczenie? Jaka jest Twoja tolerancja na kompleksność CI/CD setup?
Dla side projectów specifycznie: zacznij z monorepo używając pnpm workspaces (npm workspaces też działają, po prostu mniej ergonomicznie). Dodaj Turborepo dopiero kiedy Twój CI regularnie trafia w 4+ minut. Podziel się na osobne repo dopiero kiedy masz konkretny powód: open-source, kontrola dostępu, compliance czy partner team z różnym release cadence. Nie dlatego że czujesz że to jest architekturalnie czystsze.
Debata monorepo vs polyrepo to jeden z tych wyborów gdzie prawidłowa odpowiedź dla większości solo developerów jest taka sama: zacznij prosto, optymalizuj kiedy pojawi się konkretne tarcie. Kursor wciąż miga. Shipuj pierwszy commit.