Monorepo vs polyrepo: Det arkitekturval som hakar fast
Summary
För de flesta soloutvecklare som bygger en produkt med delad kod är monorepo rätt default i 2026. Den här guiden förklarar vad du faktiskt vinner bortom läroböckerspitchet, när polyrepo faktiskt vinner, vilka CI/CD-kostnader du ska vänta dig, och hur AI-kodningsverktyg som Cursor och Claude Code förskjutit de klassiska avvägningarna.
Monorepo vs polyrepo. Den frågan dyker upp innan varje nytt projekt, och svaret formar månader av CI/CD-setup, refaktoringskostnader och åtkomstkontroll. För de flesta soloutvecklare som bygger en produkt med delad kod är rätt default i 2026 monorepo. Inte för att det är trendigt, utan för att det tar bort publiceringsceremonin som polyrepos tvingar på dig när två paket behöver prata med varandra. Om dina tjänster är helt oberoende och aldrig någonsin ska dela kod, är polyrepo enklare. Annars är det kontext.
Det är 22:00. Du har ett nytt projekt på väg: ett API, ett paket med delad TypeScript-typer och en frontend-dashboard som oundvikligt ska konsumera båda. Två flikar öppna. Markören blinkar.
De flesta inlägg om detta skrivs för engineeringteam på tjugo personer med en dedikerad DevOps-ingenjör som älskar att konfigurera Bazel. Det här är för builders som behöver fatta beslutet före första commiten, för omstrukturering efter sex månader när du har riktiga användare och en CI-pipeline som din muskelminne redan kan utantill är den slags sak som dödar momentum i ett sidoprojekt för alltid.
Vad en monorepo faktiskt köper dig (inte läroboksvarianten)
Standardpitchet är "ett repo, delade dependencies, atomära ändringar." Det stämmer allt. Men delen som faktiskt spelar roll dag för dag för en solo builder är mer konkret: du behöver inte publicera paket för att använda dem lokalt.
I en polyrepo-setup, om shared-utils behöver en fix som också påverkar api-service, kan du antingen publicera en ny version av shared-utils, bumpa dependency i api-service, vänta på CI, och sedan deployas. Annars faller du tillbaka på npm link-hack som fungerar tills de slutar fungera mitt i en sprint. I en monorepo med workspaces ändrar du koden, och varje paket som importerar den ser ändringen omedelbar. Ingen publiceringsceremo.
Här är vad det ser ut som med pnpm workspaces, som lägger till minimal konfigurationsöverkostnad:
/packages
  /shared-types      ← importerad direkt av api och web
  /api
  /web
package.json         ← workspace root med "workspaces" fält
// api/package.json
{
"dependencies": {
"@myapp/shared-types": "workspace:*"
}
}Ingen publicering. Ingen versionsknuff under utveckling. workspace:* löses till det lokala paketet, och TypeScript:s projektreferences ger dig inkrementell kompilering över hela grafen.
Annan riktigt fördel: korspaket-refaktorering som landar i en PR. Byta namn på ett interface i shared-types? TypeScript säger dig vilka konsumenter som bröts, i samma kodbas, i samma editor-session. I polyrepo, byter du namn i repo A, publicerar en ny version, och upptäcker bristen i repo B tre dagar senare när en kollega kör npm install och typerna matchar inte körtiden längre.
Tredje fördelen, som solodevelopers underskattar: en plats för verktygsconfig. En .eslintrc, en prettier.config.js, en CI-workflow-fil. Små sparad per ändring, men de summeras under månader av iteration.
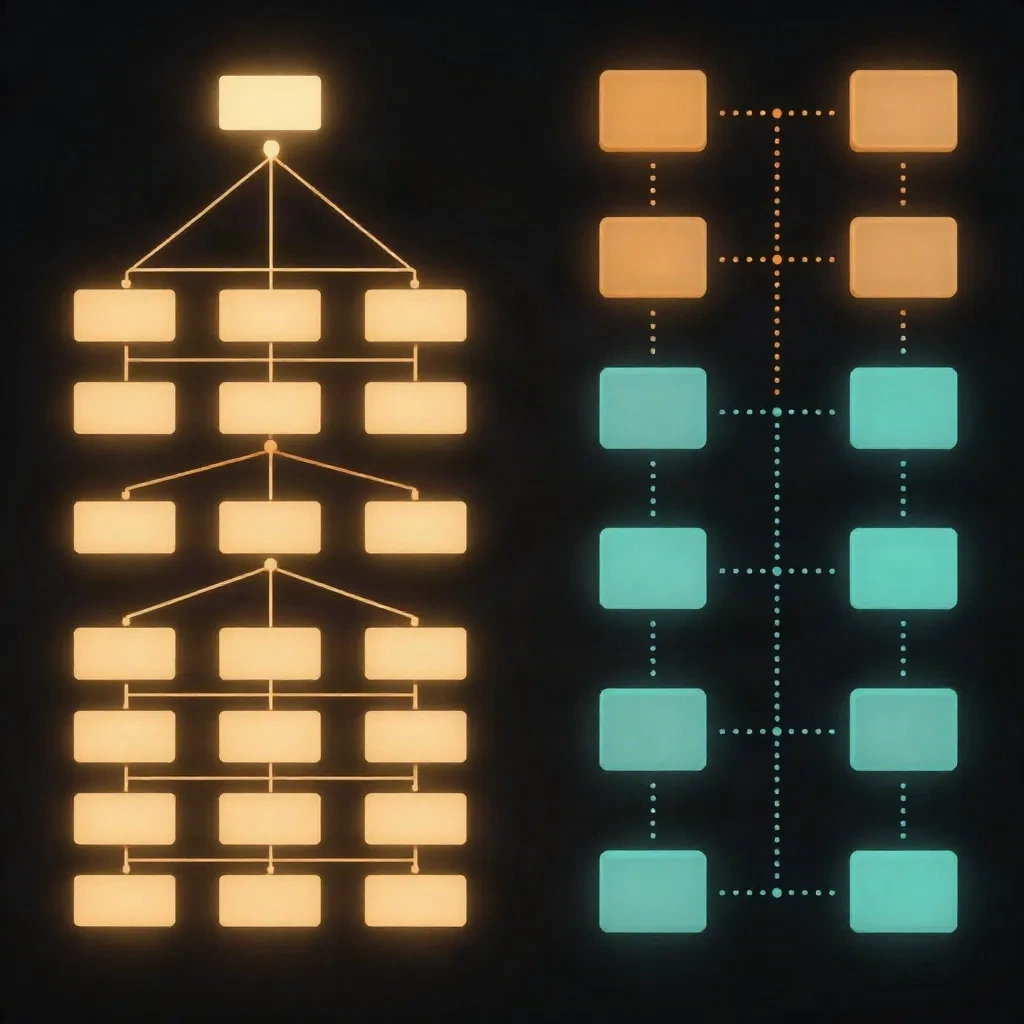
Det är värt att namnge vad monorepo inte ger dig: det gör tjänster inte mindre kopplade. Om dina tjänster är helt oberoende och du lägger dem i monorepo ändå, har du lagt till koordinationsöverkostnad utan avkastning. Monorepos fördelar materialiseras bara när tjänsterna faktiskt delar kod eller behöver ändras tillsammans. Repo-strukturen bör återspegla beroendestrukturen, inte tvinga fram en.
När polyrepo faktiskt förtjänar sin plats
Polyrepo är inte ett misstag. Det är rätt val för specifika situationer, och att låtsas annat är hur du hamnar med ett 40-tjänst-monorepo som tar 25 minuter att klona.
Klarast fall: tjänster med faktiskt olika ownership, release cycles eller compliance-krav. Om din betalingstjänst är PCI-scopad och din marknadsföringssida inte är det, innebär det att hålla åtkomstkontroll, granskningsloggar och blastradie ren separerade. Det är inte driftskostnader. Det är funktionen.
Polyrepo vinner också när du öppenkällkodiserar del av din kodbas. Ett dedikerat offentligt repo låter externa bidragsgivare forka och PR utan att dra din privata infrastruktur in i scope. GitHubs repo-nivå-behörighetmodell ger dig inte ren sökvägsbaserad åtkomstisolerig i stor skala. Ett separat repo hanterar det rätt.
Och för ren mikrotjänster med helt olika tech stacks: en Go-tjänst och en React Native-app som bokstavligt talat delar ingenting på kodnivå, lägger monorepo koordinationskostnad utan att leverera fördelen. Om det inte finns delade paket, finns det ingenting att dela.
Den ärliga versionen av det här: de flesta indie-projekt som börjar med polyrepo ångrar sig det, inte för att polyrepo är dålig arkitektur, utan för att de överskattade hur oberoende delarna skulle stanna. Frontend behöver alltid en typ från backend. Workern behöver alltid ett verktyg från API:n. Två repos blir fyra PRs för varje feature.
CI/CD-kostnaden som ingen nämner förrän den slår facturan
Monorepos har en faktisk operativ kostnad: om din CI naivt kör allt på varje commit, betalar du i tid och pengar för builds och test som inte har någonting med det du ändrade att göra.
Pusha en CSS-tweak till webpaketet. CI kör hela testsviten för api, worker och shared-types. Det är sex minuter GitHub Actions compute för en färgändring. I större skala blir detta CI-köer som blockerar hela teamet.
Lösningen finns, men den kräver medveten setup: build orchestration-verktyg som förstår din beroendegraf. Turborepo och Nx löser båda det här. Turborepos turbo.json definierar en pipeline där varje task körs bara för paket med ändrade inputs:
{
  "pipeline": {
    "build": {
      "dependsOn": ["^build"],
      "outputs": ["dist/**"]
    },
    "test": {
      "dependsOn": ["build"],
      "cache": true
    }
  }
}
Med remote caching aktiverad (gratis på Vercels Turborepo Cloud-nivå för små team) är en cache-hit på ett oförändrat paket omedelbar, ingen rebuild, ingen omtest. För en solo dev på ett sidoprojekt håller det CI under två minuter på de flesta pushar när build-artefakterna är varma.
Kostnaden: du behöver lära dig Turborepo eller Nx innan du behöver det, inte efter. Det är ungefär en halv dag setup. Om du hoppar över och låter CI samla fett kommer monorepo CI att sakta ner till punkten där du börjar ifrågasätta hela arkitekturvalet, och det är vanligt när utvecklare bestämmer sig för att polyrepo var rätt hela tiden, när det verkliga problemet bara var en saknad config-fil.
Hur AI-kodningsverktyg förskjutit matematik på denna debatt
Tills nyligen var en faktisk argument för polyrepo kognitiv belastning: mindre repos är lättare att resonera om för de är isolerade. Kontextbyte till en ny tjänst, se bara vad som är relevant för den tjänsten. Argumentet var berättigat.
AI-kodningsverktyg förskjuter den kalkylen. När du arbetar med Cursor, Claude Code eller GitHub Copilot, arbetar verktyget med din fullständiga kodbas i kontext. Det ser tjänst-till-tjänst-beroenden, förstår vilket interface som förbrukas av vilken tjänst, och kan spåra ett omöppat fält genom varje konsument utan att du håller hela mentala modellen själv. Argumentet "isolerat repo är lättare att förstå" försvagar sig signifikant när din AI-assistent håller hela beroendgrafen i kontext ändå.
Ett konkret exempel: i en polyrepo-setup, om du frågar ett AI-assistentverktyg att refaktorera en API-endpoint som också påverkar en delad typ, kan det vanligt inte se båda repos i en session. Du gör koordinationen manuellt, vilket är exakt den overheaden som monorepo skulle eliminera. I monorepo är samma refaktorering en konversation.
Det väger inte hela beslutet helt. Men det tar bort en av de historiska rättfärdigandena för polyrepo för små team och solo devs, och tippar defaultet något längre mot monorepo när koden faktiskt är kopplad.
Tre signaler som betyder att du bör dela upp repot nu
Du började med monorepo. Bra. Men här är konkreta signaler att delningen har blivit rätt samtal:
Åtkomstkontroll blir lasthållande. En kontraktör behöver frontend-åtkomst, inte backend. Ett partner-integrationsiteam behöver läsa din API-schema men ingenting proprietärt. GitHubs Codeowners kan begränsa vem som kan granska vilka sökvägar, men det begränsar inte läsåtkomst. Om läsisolerig spelar roll för compliance eller säkerhet, är separata repos det rena svaret. Codeowners gymnastics ersätter aldrig repo-nivå-behörigheter helt.
CI-fel i en tjänst blockerar deployment i en orelaterad. Om ett brutet test i payment-service blockerar en hotfix du behöver shippa i marketing-site skapar din monorepo koppling som din kodbas inte har. Antingen är build-konfigurationen i behov av fixning (task scoping med Turborepo löser det), eller tjänsterna tillhör faktiskt inte samma repo.
En del går öppen källkod och en är det inte. Det här är det renaste split-fallet. Extrahera öppen källkods-delen i sitt eget offentligt repo. Blandad offentlig/privat kod i ett GitHub-monorepo är faktiskt smärtsamt: du skulle behöva en separat organisation eller en manuell pruning-process som skapar permanent underhållsöverkostnad.
Det praktiska setupet som de flesta builders landar på
Svaret de flesta erfarna utvecklare blir överens om: ett monorepo per produktdomän, inte "ett monorepo för allt du någonsin byggde" och inte "ett repo per paket."
Om du bygger en SaaS med en webfrontend, ett API och ett delat typbibliotek, det är en produkt. Behåll det i ett monorepo. Om du även underhåller ett öppen källkods CLI-verktyg som andra projekt använder, det är ett annat repo med annan publik och release cycle.
Mistaget är att behandla monorepo/polyrepo-valet som ideologisk. Det är inte "monorepo teams" kontra "polyrepo teams." Det är ett strukturellt beslut baserat på tre frågor: Vad är beroendegrafen mellan dina tjänster? Vem behöver åtkomst till vad, och spelar isolation roll? Vad är din tolerans för CI/CD-setup komplexitet?
För sidoprojekt specifikt: börja med monorepo med pnpm workspaces (npm workspaces fungerar också, bara mindre ergonomisk). Lägg bara till Turborepo när din CI regelbundet slår 4+ minuter. Dela upp i separat repo bara när du har en konkret anledning: öppen källkod, åtkomstkontroll, compliance eller ett partner-team med annan release cadence. Inte för att det känns arkitektoniskt renare.
Monorepo kontra polyrepo-debatten är en av de val där rätt svar för de flesta solo devs är samma: börja enkelt, optimera när specifik friktion dyker upp. Markören blinkar fortfarande. Shippa första commiten.